摘要LLM 归库摘要
- 核心内容: 本文提出 GLUE(graph-linked unified embedding)框架,用图引导的统一嵌入整合非配对单细胞多组学数据,并同步进行调控推断。
- 方法要点: 为不同组学分别建立自编码器,用指导图显式编码跨组学调控关系,再通过对抗对齐获得共享细胞嵌入。
- 主要结果: 在 scRNA-seq、scATAC-seq 与 DNA 甲基化等场景下,GLUE 在准确性、鲁棒性、可扩展性和 atlas 级整合上均优于多种基线方法。
- 可复用知识: 可作为“非配对单细胞多组学整合 + 调控网络推断”的代表性方法论文,也适合对比 Seurat、LIGER、Harmony、SCENIC、Cicero 等工具链。
- 与当前研究的关系: 对单细胞转录组/染色质可及性联合分析、细胞图谱整合、调控关系挖掘具有直接参考价值,可迁移到口腔组织或肿瘤微环境多组学研究设计中。
- 关联页面建议: 后续可整合到 02 文献精读与汇报库/02_wiki/methods/单细胞多组学整合 或相关综述主题页。
- 扩展整理: 02 文献精读与汇报库/01_sources/papers/文献/2022-05-NatBiotechnol-GLUE-单细胞多组学-调控推断/Multi-omics single-cell data integration and regulatory inference with graph-linked embedding
- 下一步处理: 如需做深度精读、方法拆解、图表摘录或与现有项目对照,建议继续走
paper-import-workflow。- 归库说明: 分类到 02 文献精读与汇报库,置信度 0.98,依据为明确论文来源、完整论文章节和方法学主题。
抽象的#
尽管单细胞多组学模态同步测量的实验方法已经出现,但大多数单细胞数据集仅包含一种模态。整合多模态组学数据的主要障碍在于,不同的组学层通常具有不同的特征空间。本文提出了一种名为 GLUE(图链接统一嵌入)的计算框架,它通过显式地建模跨组学层的调控相互作用来弥合这一差距。系统性的基准测试表明,对于异构单细胞多组学数据,GLUE 比现有最先进的工具更准确、更稳健、更具可扩展性。我们将 GLUE 应用于各种具有挑战性的任务,包括三组学整合、整合调控推断以及基于数百万个细胞的多组学人类细胞图谱构建,GLUE 能够修正先前的注释。GLUE 采用模块化设计,可以灵活扩展和增强以适应新的分析任务。完整的软件包可在 https://github.com/gao-lab/GLUE 在线获取。
玩#
单细胞测序技术的最新进展使得通过多组学层面(例如染色质可及性(单细胞 ATAC 测序 (scATAC-seq) [^1] [^2] )、DNA 甲基化(snmC-seq [^3] 、sci-MET [^4] )和转录组(scRNA-seq [^5] [^6] ))探测调控图谱成为可能,为揭示不同细胞类型功能的潜在调控机制提供了独特的机会 [^7] 。尽管同步检测技术近期已出现 [^8] [^9] [^10] [^11] ,但不同组学数据通常是独立测量的,产生的是非配对数据,因此需要高效的计算机多组学整合方法 [^12] [^13] 。
在计算方面,整合非配对多组学数据(也称为对角整合)面临的一个主要障碍是不同模态的特征空间存在差异(例如,scATAC-seq 中的可及染色质区域与 scRNA-seq 中的基因) [^14] 。一种快速解决方法是基于先验知识将多模态数据转换为一个公共特征空间,然后应用单组学数据整合方法 [^15] [^16] [^17] [^18] 。这种显式的“特征转换”方法虽然简单直接,但据报道会导致信息丢失 [^19] 。基于耦合矩阵分解的算法可以避免显式转换,但几乎无法处理超过两个组学层的数据 [^20] [^21] 。另一种方法是通过非线性流形比对来匹配来自不同组学层的细胞,这完全消除了对先验知识的需求,并且理论上可以减少模态间的信息丢失 [^22] [^23] [^24] [^25] ;然而,这种技术主要应用于细胞类型数量有限的小型数据集。
数据量不断增长是另一个严峻的挑战 [^26] 。近年来发展起来的技术能够常规地生成包含数百万个单元格的数据集 [^27] [^28] [^29] ,而目前的集成方法仅应用于规模小得多的数据集 [^15] [^17] [^20] [^21] [^22] [^23] 。为了跟上数据吞吐量的增长,计算集成方法的设计应充分考虑可扩展性。
本文介绍了一种名为 GLUE(图链接统一嵌入)的模块化框架,用于整合非配对的单细胞多组学数据并同时推断调控相互作用。GLUE 通过显式地对跨组学层的调控相互作用进行建模,以生物学上直观的方式弥合了不同组学特征空间之间的鸿沟。系统性的基准测试和案例研究表明,GLUE 对异构单细胞多组学数据具有准确性、鲁棒性和可扩展性。此外,GLUE 被设计成一个通用框架,可以以模块化的方式轻松扩展并快速应用于特定场景。GLUE 可在 https://github.com/gao-lab/GLUE 公开访问。
结果#
基于图引导嵌入的非配对多组学整合#
受先前研究的启发,我们将细胞状态建模为通过变分自编码器学习的低维细胞嵌入 [^30] [^31] 。鉴于它们在生物学性质和检测技术方面的内在差异,每个组学层都配备了一个单独的自编码器,该自编码器使用针对特定层特征空间量身定制的概率生成模型(图 1 和 方法 )。
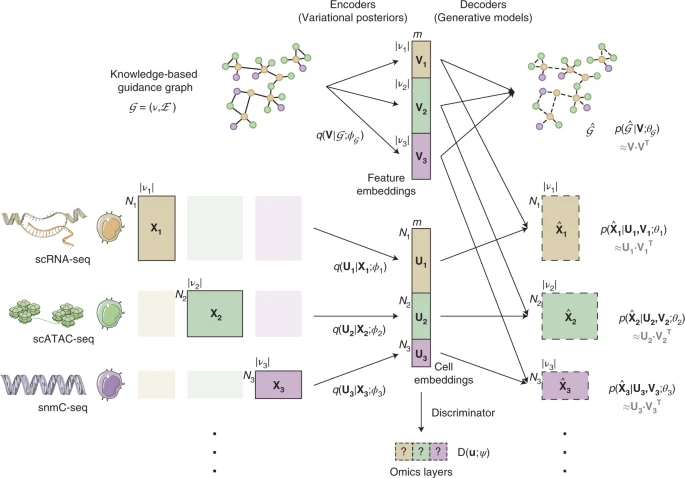
图 1:GLUE 框架的架构。
利用已有的生物学知识,我们提出使用一种基于知识的图谱(“指导图”),该图谱显式地建模跨层调控相互作用,以连接各层特异性特征空间;图中的顶点对应于不同组学层的特征,边代表有符号的调控相互作用。例如,在整合单细胞 RNA 测序(scRNA-seq)和单细胞 ATAC 测序(scATAC-seq)数据时,顶点是基因和可及染色质区域(即 ATAC 峰),一条正边可以连接一个可及区域及其假定的下游基因。然后,以图 [^32] 编码的特征嵌入为指导,对细胞进行对抗性多模态比对,这是一个迭代优化过程(图 1 和 方法部分 )。值得注意的是,当迭代过程收敛时,可以利用比对过程的输入来优化该图谱,并将其用于面向数据的调控推断(详见下文)。
系统性基准测试表明其性能优异#
我们首先使用最近同步 scRNA-seq 和 scATAC-seq 技术生成的三个黄金标准数据集(SNARE-seq [^8] 、SHARE-seq [^9] 和 10X Multiome [^34] )以及两个非配对数据集(Nephron [^35] 和 MOp [^36] )对 GLUE 与多种流行的非配对多组学整合方法 15,16,17,18,23,24,25,33 进行了基准测试。
有效的整合方法应匹配来自不同组学层的相应细胞状态,从而生成能够忠实保留生物学变异且组学层混合良好的细胞嵌入。与其他方法相比,GLUE 同时实现了高水平的生物学保留和组学混合(图 2a ,分别由扩展数据图 1 所示的三个独立指标量化),并且在所有基准数据集上,其总体得分始终是最佳方法(图 2b ,有关指标聚合的详细信息,请参见 “方法 ”部分);这些结果也通过对齐细胞嵌入的均匀流形近似和投影 (UMAP) 可视化得到了验证(补充图 1-5 ) 。
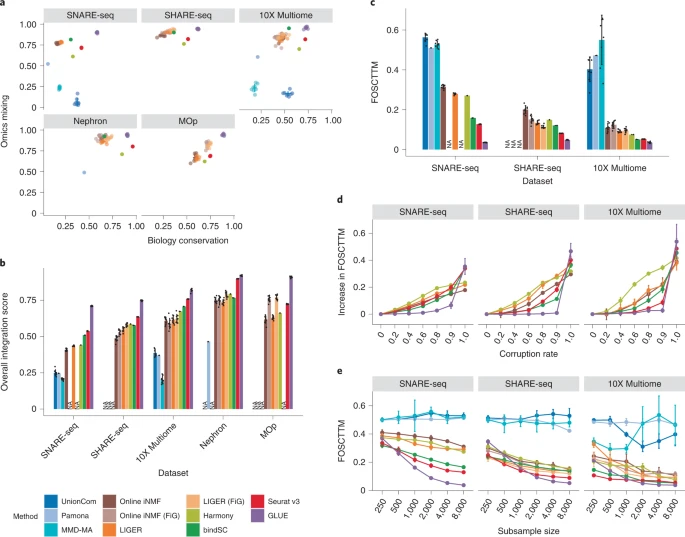
图 2:集成性能的系统基准。
理想的整合方法不仅应在细胞类型层面,而且应在更精细的尺度上产生精确的比对结果。利用黄金标准数据集中真实的细胞间对应关系,我们进一步通过 FOSCTTM(比真实匹配更接近的样本比例)指标 [^25] 量化了单细胞水平的比对误差。在所有三个数据集上,GLUE 均实现了最低的 FOSCTTM 值,与每个数据集上的第二佳方法相比,其比对误差显著降低(图 2c ,SNARE-seq 数据集降低了 3.6 倍,SHARE-seq 数据集降低了 1.7 倍,10X Multiome 数据集降低了 1.5 倍)。
在上述评估过程中,我们采用了一种标准方案(如果 ATAC 峰与 RNA 基因在基因体或近端启动子区域重叠,则将它们关联起来)来构建 GLUE 的指导图,并用于其他基于转换的方法的特征转换。鉴于我们目前对调控相互作用的了解仍然远非完美,一个有效的整合方法必须能够应对此类误差。因此,我们通过随机替换不同比例的现有相互作用,进一步评估了这些方法对调控相互作用数据错误(例如不存在的相互作用)的鲁棒性。对于所有三个数据集,即使在高达 90%的错误率下,GLUE 的性能变化也最小(图 2d 和扩展数据图 2a ),表明其具有卓越的鲁棒性。同样,我们发现使用在更大基因组窗口中定义的替代指导图对整合性能的影响微乎其微(扩展数据图 2b、c )。
鉴于 GLUE 基于神经网络的特性,在处理小型数据集时可能会出现欠训练的情况。因此,我们使用不同大小的子采样数据集重复了评估。即使只有 2000 个细胞,GLUE 仍然是排名最高的算法,但当数据量减少到少于 1000 个细胞时,对齐误差急剧增加(图 2e 和扩展数据图 2d )。此外,我们还注意到,GLUE 的集成性能在各种超参数和特征选择设置下都表现出良好的鲁棒性(扩展数据图 3 和图 4 )。除了细胞嵌入之外,GLUE 的特征嵌入也对超参数设置、先验知识的破坏和数据子采样表现出相当强的鲁棒性(扩展数据图 5 )。
除了组学层之间的系统性差异外,单细胞数据还常常受到同一层内批次效应的影响。例如,SHARE-seq 数据在四个文库中进行处理,其中一个文库在 scRNA-seq 中与其他三个文库相比显示出批次效应(补充图 6a );而肾单位数据分析了四个供体,所有供体在 scRNA-seq 和 scATAC-seq 中均显示出显著的批次效应(补充图 7a,c )。为了解决此类复杂情况,GLUE 通过将批次作为解码器协变量纳入其中,提供了批次校正功能( 方法 )。启用批次校正后,GLUE 能够有效地校正这些批次效应,从而显著改善批次混合(补充图 6b 和补充图 7b,d )。为了防止过度校正(例如,在强制整合缺乏共同细胞状态的数据集时),我们设计了一种称为整合一致性评分的诊断指标,用于衡量整合后的多组学空间与指导图中的先验知识之间的一致性( 方法 )。我们观察到,整合来自不一致组织的数据时,其评分显著低于整合同一组织内的数据(接近于 0),这使其成为衡量整合质量的可靠指标(扩展数据图 6 )。
GLUE 可实现有效的三组学整合#
得益于模块化设计和可扩展的对抗比对,GLUE 可以轻松扩展到两个以上的组学层。作为案例研究,我们使用 GLUE 整合了成年小鼠皮层神经元细胞的三个不同的组学层,包括基因表达 [^37] 、染色质可及性 [^38] 和 DNA 甲基化 [^3] 。
与染色质可及性不同,基因体 DNA 甲基化在神经元细胞中通常与基因表达呈负相关 [^39] 。GLUE 通过在引导图中对边的符号进行建模,原生支持多种调控效应的混合。这种策略避免了数据反转,而数据反转是先前方法 [^16] [^17] 所必需的,并且会破坏数据的稀疏性和潜在的分布。对于三组学引导图,我们通过负边将基因体 mCH 和 mCG 水平与基因连接起来,而可及区域与基因之间的正边保持不变。
GLUE 比对成功揭示了三个组学层中共享的细胞状态流形(图 3a-d )。值得注意的是,原始细胞类型的注释分辨率并不相同,许多细胞类型即使在单个组学层内也能进一步聚类成更小的亚型(补充图 8a-f )。为了统一细胞类型注释,我们使用整合的细胞嵌入进行了基于邻近的标签转移,并观察到 14 种映射细胞类型中的 12 种具有高度显著的标记重叠(图 3e ,三维 Fisher 精确检验 [^40] ,错误发现率(FDR) < 5 × 10⁻¹})(补充图 8g-o 和 9 以及 方法 ),表明比对结果可靠。 GLUE 比对有助于改善所有组学层中的细胞分型效果,包括将 scRNA-seq 'MGE' 簇进一步划分为 Pvalb + ('mPv') 和 Sst + ('mSst') 亚型(图 3 和补充图 8 中用绿色圆圈/流式标记),将 scRNA-seq 'CGE' 簇和 scATAC-seq 'Vip' 簇划分为 Vip + ('mVip') 和 Ndnf + ('mNdnf') 亚型(图 3 和补充图 8 中用深蓝色圆圈/流式标记),以及将 snmC-seq 'mDL-3' 细胞和部分 scATAC-seq 'L6 IT' 细胞鉴定为屏状核细胞(图 3 和补充图 8 中用浅蓝色圆圈/流式标记)。 8 )。
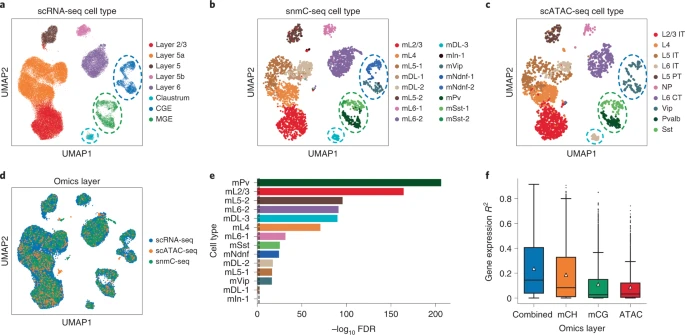
图 3:小鼠皮层的三组学整合。
这种三组学整合也揭示了不同表观遗传调控机制的定量贡献( 方法 )。在 mCH、mCG 和染色质可及性中,我们发现 mCH 水平对皮层神经元基因表达的预测能力最高(平均 R 2 = 0.187)。当考虑所有表观遗传层时,表达预测能力进一步提高(平均 R 2 = 0.236),表明存在非冗余的贡献(图 3f )。在不同层的神经元中,DNA 甲基化(尤其是 mCH)对深层神经元基因表达的预测能力略高于浅层神经元(补充图 10a )。在所有基因中,不同表观遗传层之间的基因表达预测能力普遍相关(补充图 10b )。我们也观察到基因特征与预测能力之间存在不同的关联。例如,mCH 对较长基因的表达预测能力更高,这与之前的研究结果一致 [^17] [^41] ,而染色质可及性对表达变异性较高的基因贡献更大(补充图 10c )。我们还使用在线 iNMF 重复了相同的分析,iNMF 是目前唯一能够同时整合三个组学层的方法,但其细胞类型分辨率和表观遗传相关性均显著降低(补充图 11 )。
利用 GLUE 进行整合调控推断#
GLUE 中显式建模调控相互作用的图的引入,进一步实现了类似贝叶斯的方法,该方法结合了先验知识和观测数据进行后验调控推断。具体而言,由于特征嵌入旨在同时重建基于知识的指导图和单细胞多组学数据(图 1 ),它们的余弦相似度应反映来自这两个方面的信息,我们将其作为“调控评分”。
作为演示,我们使用了来自 10X 的官方外周血单核细胞多组数据集 [^34] ,并将其作为非配对的单 细胞 RNA 测序 (scRNA-seq) 和单细胞 ATAC 测序 (scATAC-seq) 数据输入到 GLUE 中。为了捕获远程顺式调控相互作用,我们使用了一个长程引导图,该图连接了 150 kb 窗口内的 ATAC 峰和 RNA 基因,并以幂律函数加权,该函数模拟染色质接触概率 [^42] [^43] ( 方法 )。细胞嵌入的可视化证实了 GLUE 比对的正确性和准确性(补充图 12a,b )。正如预期的那样,我们发现调控评分与基因组距离呈负相关(图 4a ),与经验峰-基因相关性(使用配对细胞计算,图 4b )呈正相关,并且在不同的随机种子下均具有稳健性(补充图 12c )。
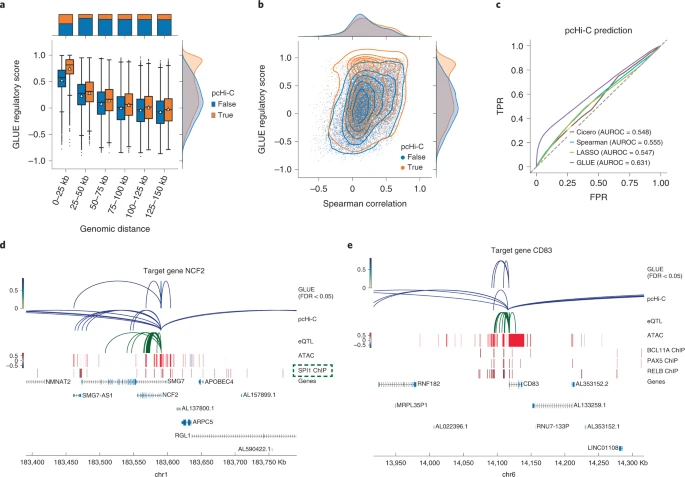
图 4:外周血单核细胞中的整合调控推断。
为了进一步评估该评分是否反映了实际的 顺式 调控相互作用,我们将其与外部证据进行了比较,包括 pcHi-C [^44] 和 eQTL [^45] 。在所有距离范围内,pcHi-C 支持的峰-基因对的 GLUE 调控评分均较高(图 4a ),并且比经验峰-基因相关性(图 4b )以及基于共可及性的调控预测方法 LASSO 和 Cicero [^43] 更能有效地预测 pcHi-C 相互作用(图 4c 和补充图 12d )。eQTL 也呈现出相同的结果(补充图 12e-h )。
GLUE 框架还允许通过引导图直观地整合额外的调控证据,例如 pcHi-C。因此,我们进一步使用包含距离加权互作以及 pcHi-C 和 eQTL 支持的互作的复合引导图训练模型(补充图 13 )。通过将其与从随机打乱的特征嵌入中获得的零分布进行比较来评估调控评分的显著性( 方法 )。正如预期的那样,虽然多组学比对对引导图的变化不敏感,但推断的调控互作显示出 pcHi-C 和 eQTL 的更强富集(补充图 13a-d )。即使这些互作在引导图中受到干扰,也能稳健地恢复大部分同时受到 pcHi-C、eQTL 和相关性支持的高置信度互作(FDR < 0.05)(补充图 13e )。此外,GLUE 衍生的转录因子 (TF) 靶基因网络( 方法 )与 TRRUST v2 数据库中手动整理的连接相比,与单个基于证据的网络相比,显示出更高的一致性(补充图 13f 和补充图 14 和补充数据 2 )。
我们注意到,GLUE 推断的 顺式 调控相互作用可以为已知转录因子-靶标对的调控机制提供线索。例如,SPI1 是 NCF2 基因的已知调控因子,两者在单核细胞中均高表达(补充图 15a,b )。GLUE 利用多种证据识别出 NCF2 的三个远端调控峰,分别位于转录起始位点(TSS)下游约 120 kb、下游约 25 kb 和上游约 20 kb 处(图 4d ),所有这些调控峰均与 SPI1 结合。同时,大多数推定的调控相互作用此前未知。例如, CD83 与三个调控峰相关联(两个位于 TSS 上游约 25 kb 处,一个位于 TSS 上游约 10 kb 处),这些调控峰富集了三个转录因子(BCL11A、PAX5 和 RELB)的结合(图 4e )。 CD83 在单核细胞和 B 细胞中均高表达,但推断的转录因子(TFs)的表达模式更为局限(补充图 15c-f ),提示其活性调控因子可能因细胞类型而异。补充图 16 展示了更多 GLUE 推断的调控相互作用实例。
利用 GLUE 对数百万个细胞进行 Atlas 级集成#
随着技术的不断发展,单细胞实验的通量也在不断提高。近期研究已构建了包含数百万个细胞的人类基因表达 [^28] 和染色质可及性 [^29] 细胞图谱。由于数据量庞大、异质性极高、每个细胞的覆盖率低以及细胞类型组成不平衡等问题,这些图谱的整合对计算方法提出了巨大的挑战,目前尚未在单细胞水平上实现。
GLUE 是一种采用小批量优化算法的神经网络,具有优异的可扩展性和亚线性时间成本,有望应用于图谱规模(补充图 17a )。我们利用高效的 GLUE 多阶段训练策略( 方法部分 ),成功地将基因表达和染色质可及性数据整合到一个统一的多组学人类细胞图谱中(图 5 )。
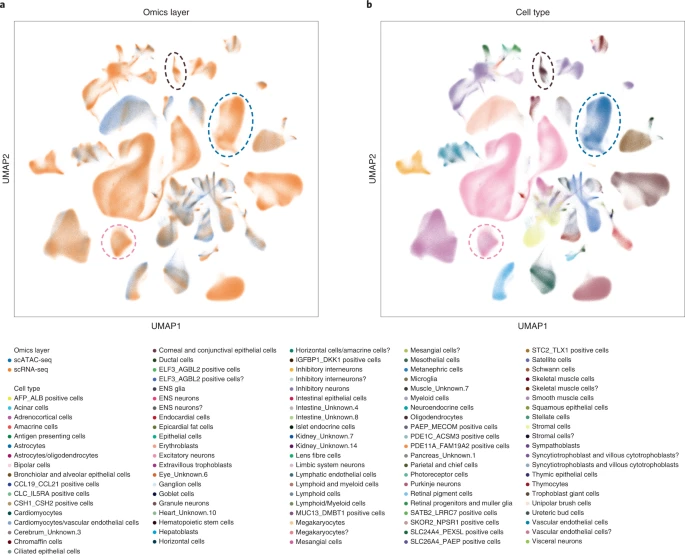
图 5:多组学人类细胞图谱的整合。
虽然比对后的图谱与原始注释基本一致 [^29] (补充图 17c-e ),但我们也注意到一些差异。例如,在 scATAC-seq 中最初注释为“星形胶质细胞”的细胞,在 scRNA-seq 中被比对到“兴奋性神经元”簇(补充图 17 中以粉色圆圈/流线突出显示)。进一步检查发现,该簇中典型的放射状胶质细胞标记物,如 PAX6 、 HES1 和 HOPX [^47] [^48] ,在 RNA 和 ATAC 结构域均有活跃转录(补充图 18 ),并且在神经元和胶质细胞标记物处也检测到了染色质启动 [^9] (补充图 19-21 ),这表明该簇由多能神经祖细胞(可能是放射状胶质细胞标记物)组成 , 而不是最初注释的兴奋性神经元或星形胶质细胞。基于 GLUE 的整合方法还解决了几个注释不明确的 scATAC-seq 簇。例如,“星形胶质细胞/少突胶质细胞”簇被拆分为两部分,并分别与 scRNA-seq 的“星形胶质细胞”和“少突胶质细胞”簇比对(在补充图 17 中分别用蓝色和棕色圆圈/流线突出显示),这也得到了标记表达和可及性分析的支持(补充图 20 和 21 )。这些结果展示了图谱级多组学整合的独特价值,它能够在不损失单细胞分辨率的情况下,以无偏倚、数据导向的方式跨模态进行细胞分型。特别是,引入批次校正可以进一步实现以整合图谱为全局参考的新数据集的有效整理 [^49] 。
相比之下,我们也尝试使用在线 iNMF 进行数据整合,这是唯一能够全尺度整合数据的方法,但结果远非最佳(补充图 22a、b 和 23 )。同时,尝试使用常用的 Seurat v3 方法将数据作为聚合元单元进行整合( 方法 )也失败了(补充图 22c、d )。
讨论#
GLUE 框架结合了组学特异性自编码器、基于图的耦合和对抗比对,能够以卓越的准确性和鲁棒性整合非配对单细胞多组学数据。通过显式地建模跨组学层的调控相互作用,GLUE 独特地支持对非配对多组学数据集进行整合调控推断。值得注意的是,在贝叶斯解释中,GLUE 的调控推断可以被视为后验估计,并可根据新数据的到来不断进行改进。
非配对多组学整合在概念上与批次效应校正 [^50] 有一些相似之处,但前者由于具有独特的、组学特有的特征空间而更具挑战性。虽然特征转换看似是一个简单的解决方案,但不可避免的信息损失 [^19] 可能会造成不利影响。Seurat v3(参考文献 [^15] )和 bindSC [^33] 也设计了启发式策略,除了转换后的数据外,还利用了原始特征空间中的信息,这或许可以解释它们比未采用这些策略的方法性能更优的原因 [^16] [^17] 。同时,已知的细胞类型也被用于通过(半)监督学习来指导整合 [^51] [^52] ,但这种方法在适用性方面存在很大的局限性,因为这种监督通常不可用,而且在许多情况下,这种监督本身就是多组学整合的目的 [^29] 。值得注意的是,其中一种方法采用了类似的自编码器架构和对抗比对 [^52] ,但它依赖于匹配的细胞类型或聚类来指导比对方向。事实上,GLUE 与耦合矩阵分解方法 [^20] [^21] 在概念上更为相似,但性能更优,这主要得益于其基于深度生成模型的设计。
我们注意到,当前框架也适用于整合具有共享特征的组学层(例如,scRNA-seq 和空间转录组学之间的整合 [^53] [^54] ),方法是在指导图中为共享特征使用相同的顶点或连接的代理顶点。此外,还可以通过链接不同组学层的编码器和解码器来实现交叉插补。然而,鉴于最近有报告指出数据插补可能会引入人为误差并降低基因调控推断的准确性 [^55] ,因此该功能可能需要进一步研究。
GLUE 作为一个通用框架,采用模块化设计,其中数据和图自编码器可以独立配置。
近年来,实验性多组学技术的进步提高了配对数据的可用性 [^8] [^9] [^10] [^11] [^34] 。尽管目前大多数同步多组学方案的数据质量或通量仍低于单组学方法 [^64] ,但配对细胞在锚定不同组学层方面具有极高的信息价值,因此应尽可能与非配对细胞结合使用。扩展 GLUE 框架以纳入此类配对信息是直接的,例如,可以通过添加损失项来惩罚配对细胞之间的嵌入距离 [^65] 。这种扩展最终可能为嵌合体整合的一般情况提供解决方案 [^14] 。
除了多组学整合之外,我们还注意到 GLUE 框架可能适用于跨物种整合,尤其是在涉及远缘物种且一对一直系同源基因有限的情况下。具体而言,我们可以将所有直系同源基因编译成 GLUE 指导图,并在无需显式进行直系同源基因转换的情况下进行整合。在这种情况下,GLUE 方法在概念上也可以与最近一项名为 SAMap 的工作相联系 [^66] 。
最后,我们注意到,当前 GLUE 模型推断的调控相互作用是基于整个输入数据集,并且可能是多个时空特异性回路的聚合,尤其对于来自不同组织的数据(例如,图谱)而言更是如此。同时,我们注意到,与粗尺度全局模型(例如,全图谱整合模型)并行,可以通过在来自单个组织的细胞上训练专用模型来进行更精细尺度的调控推断,并可能结合时空特异性先验知识 [^67] 。这种“逐步细化”的扩展将有效地帮助识别时空特异性调控回路和关键调控因子。
我们相信,GLUE 作为一个模块化且通用的框架,为通过大规模多组学整合在单细胞分辨率下有效构建基因调控图谱提供了前所未有的机遇。GLUE 的完整软件包,包括教程和演示案例,均可在 https://github.com/gao-lab/GLUE 在线获取,供社区使用。
方法#
GLUE 框架#
$p \left(\right. \mathbf{x}{k} ; \theta{k} \left.\right) = \int p \left(\right. \mathbf{x}{k} \left|\right. \mathbf{u} ; \theta{k} \left.\right) p \left(\right. \mathbf{u} \left.\right) d \mathbf{u}$ $$ \begin{array}{*{20}{c}} {p\left( {{{{\mathbf{x}}}}_k;\theta _k} \right) = {\int} p \left( {{{{\mathbf{x}}}}_k|{{{\mathbf{u}}}};\theta _k} \right)p\left( {{{\mathbf{u}}}} \right){\mathrm{d}}{{{\mathbf{u}}}}} \end{array} $$
(1)
$\mathcal{L}{\mathcal{X}{k}} \left(\right. \phi_{k} , \theta_{k} \left.\right) & = & \mathbb{E}{\mathbf{x}{k} sim p_{d a t a} \left(\right. \mathbf{x}{k} \left.\right)} \left[\right. \mathbb{E}{\mathbf{u} sim q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} ; \phi{k} \left.\right)} log p \left(\right. \mathbf{x}{k} \left|\right. \mathbf{u} ; \theta{k} \left.\right) \ - K L \left(\right. q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} ; \phi{k} \left.\right) \parallel p \left(\right. \mathbf{u} \left.\right) \left.\right) \left]\right.$ $$ \begin{array}{rcl}{{{\mathcal{L}}}}_{{{{\mathcal{X}}}}_k}\left( {\phi _k,\theta k} \right) & = & {\Bbb E}{{{{\mathbf{x}}}}k \sim p{{{{\mathrm{data}}}}}\left( {{{{\mathbf{x}}}}k} \right)}\left[ {{\Bbb E}{{{{\mathbf{u}}}} \sim q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k;\phi _k} \right)}\log p\left( {{{{\mathbf{x}}}}_k|{{{\mathbf{u}}}};\theta _k} \right)}\right. \ && \left.{ - {{{\mathrm{KL}}}}\left( {q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k;\phi _k} \right)\parallel p\left( {{{\mathbf{u}}}} \right)} \right)} \right]\end{array} $$
(2)
由于不同的自编码器是独立参数化并在不同的数据上训练的,因此,除非正确连接,否则为不同组学层学习到的细胞嵌入可能具有不一致的语义含义。
我们将引导图视为观测变量,并将其建模为由低维特征潜在变量(即特征嵌入) $\mathbf{v}{i} \in \mathbb{R}^{m} , i \in \mathcal{V}$ 生成。此外,与之前的模型不同,我们现在将 x k 建模为由特征潜在变量 $\mathbf{v}{i} \in \mathbb{R}^{m} , i \in \mathcal{V}_{k}$ 和单元潜在变量 $\mathbf{u} \in \mathbb{R}^{m}$ 的组合生成。为方便起见,我们引入符号 $\mathbf{V} \in \mathbb{R}^{m \times \left|\right. \mathcal{V} \left|\right.}$ ,它将所有特征嵌入组合成一个矩阵。因此,模型似然函数可以写成:
$p \left(\right. \mathbf{x}{k} , \mathcal{G} ; \theta{k} , \theta_{\mathcal{G}} \left.\right) = \int p \left(\right. \mathbf{x}{k} \left|\right. \mathbf{u} , \mathbf{V} ; \theta{k} \left.\right) p \left(\right. \mathcal{G} \left|\right. \mathbf{V} ; \theta_{\mathcal{G}} \left.\right) p \left(\right. \mathbf{u} \left.\right) p \left(\right. \mathbf{V} \left.\right) d \mathbf{u} d \mathbf{V}$ $$ \begin{array}{*{20}{c}} {p\left( {{{{\mathbf{x}}}}_k,{{{\mathcal{G}}}};\theta _k,\theta _{{{\mathcal{G}}}}} \right) = {\int} p \left( {{{{\mathbf{x}}}}_k|{{{\mathbf{u}}}},{{{\mathbf{V}}}};\theta _k} \right)p\left( {{{{\mathcal{G}}}}|{{{\mathbf{V}}}};\theta _{{{\mathcal{G}}}}} \right)p\left( {{{\mathbf{u}}}} \right)p\left( {{{\mathbf{V}}}} \right){\mathrm{d}}{{{\mathbf{u}}}}{\mathrm{d}}{{{\mathbf{V}}}}} \end{array} $$
(3)
$p \left(\right. \mathbf{u} \left.\right) = N \left(\right. \mathbf{u} ; 0 , \mathbf{I}_{m} \left.\right)$ $$ \begin{array}{*{20}{c}} {p\left( {{{\mathbf{u}}}} \right) = N\left( {{{{\mathbf{u}}}};\mathbf{0},{{{\mathbf{I}}}}_m} \right)} \end{array} $$
(4)
$p \left(\right. \mathbf{v}{i} \left.\right) = N \left(\right. \mathbf{v}{i} ; 0 , \mathbf{I}{m} \left.\right) , p \left(\right. \mathbf{V} \left.\right) = \underset{i \in \mathcal{V}}{\prod} p \left(\right. \mathbf{v}{i} \left.\right)$ $$ \begin{array}{*{20}{c}} {p\left( {{{{\mathbf{v}}}}_i} \right) = N\left( {{{{\mathbf{v}}}}_i;\mathbf{0},{{{\mathbf{I}}}}m} \right),p\left( {{{\mathbf{V}}}} \right) = \mathop {\prod }\limits{i \in {{{\mathcal{V}}}}} p\left( {{{{\mathbf{v}}}}_i} \right)} \end{array} $$
(5)
$log p \left(\right. \mathcal{G} \left|\right. \mathbf{V} ; \theta_{\mathcal{G}} \left.\right) = \mathbb{E}{i , j sim p \left(\right. i , j ; w{i j} \left.\right)} \ \left[\right. log \sigma \left(\right. s_{i j} \mathbf{v}{i}^{\top} \mathbf{v}{j} \left.\right) + \mathbb{E}{j ′ sim p{n s} \left(\right. j ′ \left|\right. i \left.\right)} log \left(\right. 1 - \sigma \left(\right. s_{i j} \mathbf{v}{i}^{\top} \mathbf{v}{j ′} \left.\right) \left.\right) \left]\right.$ $$ \begin{array}{rcl} {\log p\left( {{{{\mathcal{G}}}}|{{{\mathbf{V}}}};\theta {{{\mathcal{G}}}}} \right)} = {{\Bbb E}{i,j \sim p\left( {i,j;w_{ij}} \right)}} \ {\left[ {\log \sigma \left( {s_{ij} {{{\mathbf{v}}}}i^ \top {{{\mathbf{v}}}}j} \right) + {\Bbb E}{j\prime \sim p{{{{\mathrm{ns}}}}}\left( {j\prime |i} \right)}\log \left( {1 - \sigma \left( {s_{ij} {{{\mathbf{v}}}}i^ \top {{{\mathbf{v}}}}{j\prime }} \right)} \right)} \right]} \end{array} $$
(6)
$p \left(\right. \mathbf{x}{k} \left|\right. \mathbf{u} , \mathbf{V} ; \theta{k} \left.\right) = \underset{i \in \mathcal{V}{k}}{\prod} N B \left(\right. \mathbf{x}{k}{i} ; \mu{i} , \theta_{i} \left.\right)$ $$ \begin{array}{*{20}{c}} {p\left( {{{{\mathbf{x}}}}k|{{{\mathbf{u}}}},{{{\mathbf{V}}}};\theta k} \right) = \mathop {\prod }\limits{i \in {{{\mathcal{V}}}}k} {{{\mathrm{NB}}}}\left( {{{\mathbf{x}}{k}}{i};\mathbf{\mu} _i,\mathbf{\theta} _i} \right)} \end{array} $$
(7)
$N B \left(\right. \mathbf{x}{k}{i} ; \mu_{i} , \theta_{i} \left.\right) = \frac{\Gamma \left(\right. \mathbf{x}{k}{i} + \theta_{i} \left.\right)}{\Gamma \left(\right. \theta_{i} \left.\right) \Gamma \left(\right. \mathbf{x}{k}{i} + 1 \left.\right)} \left(\left(\right. \frac{\mu_{i}}{\theta_{i} + \mu_{i}} \left.\right)\right)^{\mathbf{x}{k}{i}} \left(\left(\right. \frac{\theta_{i}}{\theta_{i} + \mu_{i}} \left.\right)\right)^{\theta_{i}}$ $$ \begin{array}{*{20}{c}} {{\mathrm{NB}}\left( {{{\mathbf{x}}{k}}{i};{{{\mathbf{\mu }}}}i,{{{\mathbf{\theta }}}}i} \right) = \frac{{{{{\mathrm{{\Gamma}}}}}\left( {{{\mathbf{x}}{k}}{i} + {{{\mathbf{\theta }}}}i} \right)}}{{{{{\mathrm{{\Gamma}}}}}\left( {{{{\mathbf{\theta }}}}i} \right){{{\mathrm{{\Gamma}}}}}\left( {{{\mathbf{x}}{k}}{i} + 1} \right)}}\left( {\frac{{{{{\mathbf{\mu }}}}_i}}{{{{{\mathbf{\theta }}}}i + {{{\mathbf{\mu }}}}i}}} \right)^{{\mathbf{x}{k}}{i}}\left( {\frac{{{{{\mathbf{\theta }}}}_i}}{{{{{\mathbf{\theta }}}}_i + {{{\mathbf{\mu }}}}_i}}} \right)^{{{{\mathbf{\theta }}}}_i}} \end{array} $$
(8)
$\mu_{i} = S o f t m a x_{i} \left(\right. \alpha \bigodot \mathbf{V}{k}^{\top} \mathbf{u} + \beta \left.\right) \cdot \underset{j \in \mathcal{V}{k}}{\sum} \mathbf{x}{k}{j}$ $$ \begin{array}{*{20}{c}} {{{{\mathbf{\mu }}}}_i = {{{\mathrm{Softmax}}}}i\left( {{{{\mathbf{\alpha }}}} \odot {{{\mathbf{V}}}}k^ \top {{{\mathbf{u}}}} + {{{\mathbf{\beta }}}}} \right) \cdot \mathop {\sum }\limits{j \in {{{\mathcal{V}}}}k} {\mathbf{x}{k}}{j}} \end{array} $$
(9)
其中, $\mu , \theta \in \mathbb{R}{+}^{\left|\right. \mathcal{V}{k} \left|\right.}$ 分别表示负二项分布的均值和离散度, $\alpha \in \mathbb{R}{+}^{\left|\right. \mathcal{V}{k} \left|\right.} , \beta \in \mathbb{R}^{\left|\right. \mathcal{V}{k} \left|\right.}$ 表示缩放因子和偏差因子, ⊙ 表示 Hadamard 积,Softmax 表示 softmax 输出的第 i 个维度, $\sum{j \in \mathcal{V}{k}} \mathbf{x}{k}{j}$ 表示单元格中的总计数。取 softmax 值并乘以总计数,可确保重建数据集的库大小与原始数据集 [^30] 相匹配。可学习参数集为 $\theta{k} = \left{\right. \theta , \alpha , \beta \left.\right}$ 。类似地,只要我们能够通过特征单元内积来参数化分布的均值,就可以支持许多其他分布。
为了实现高效的推理和优化,我们引入如下因子化变分后验分布:
$q \left(\right. \mathbf{u} , \mathbf{V} \left|\right. \mathbf{x}{k} , \mathcal{G} ; \phi{k} , \phi_{\mathcal{G}} \left.\right) = q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} ; \phi{k} \left.\right) \cdot q \left(\right. \mathbf{V} \left|\right. \mathcal{G} ; \phi_{\mathcal{G}} \left.\right)$ $$ \begin{array}{*{20}{c}} {q\left( {{{{\mathbf{u}}}},{{{\mathbf{V}}}}|{{{\mathbf{x}}}}_k,{{{\mathcal{G}}}};\phi _k,\phi _{{{\mathcal{G}}}}} \right) = q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k;\phi _k} \right) \cdot q\left( {{{{\mathbf{V}}}}|{{{\mathcal{G}}}};\phi _{{{\mathcal{G}}}}} \right)} \end{array} $$
(10)
$q \left(\right. \mathbf{V} \left|\right. \mathcal{G} ; \phi_{\mathcal{G}} \left.\right) = \underset{i \in \mathcal{V}}{\prod} q \left(\right. \mathbf{v}{i} \left|\right. \mathcal{G} ; \phi{\mathcal{G}} \left.\right)$ $$ \begin{array}{*{20}{c}} {q\left( {{{{\mathbf{V}}}}|{{{\mathcal{G}}}};\phi {{{\mathcal{G}}}}} \right) = \mathop {\prod }\limits{i \in {{{\mathcal{V}}}}} q\left( {{{{\mathbf{v}}}}_i|{{{\mathcal{G}}}};\phi _{{{\mathcal{G}}}}} \right)} \end{array} $$
(11)
$q \left(\right. \mathbf{v}{i} \left|\right. \mathcal{G} ; \phi{\mathcal{G}} \left.\right) = N \left(\right. \mathbf{v}{i} ; G C N{\mu_{i}} \left(\right. \mathcal{G} ; \phi_{\mathcal{G}} \left.\right) , G C N_{\sigma_{i}^{2}} \left(\right. \mathcal{G} ; \phi_{\mathcal{G}} \left.\right) \left.\right)$ $$ \begin{array}{*{20}{c}} {q\left( {{{{\mathbf{v}}}}_i|{{{\mathcal{G}}}};\phi _{{{\mathcal{G}}}}} \right) = N\left( {{{{\mathbf{v}}}}i;{{{\mathrm{GCN}}}}{{{{\mathbf{\mu }}}}_i}\left( {{{{\mathcal{G}}}};\phi {{{\mathcal{G}}}}} \right),{{{\mathrm{GCN}}}}{{{{\mathbf{\sigma }}}}_i^2}\left( {{{{\mathcal{G}}}};\phi _{{{\mathcal{G}}}}} \right)} \right)} \end{array} $$
(12)
$q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} , \mathbf{V}{k} ; \phi_{k} \left.\right) = N \left(\right. \mathbf{u} ; M L P_{k , \mu} \left(\right. \mathbf{x}{k} ; \phi{k} \left.\right) , M L P_{k , \sigma^{2}} \left(\right. \mathbf{x}{k} ; \phi{k} \left.\right) \left.\right)$ $$ \begin{array}{*{20}{c}} {q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k,{{{\mathbf{V}}}}_k;\phi k} \right) = N\left( {{{{\mathbf{u}}}};{{{\mathrm{MLP}}}}{k,{{{\mathbf{\mu }}}}}\left( {{{{\mathbf{x}}}}_k;\phi k} \right),{{{\mathrm{MLP}}}}{k,{{{\mathbf{\upsigma }}}}^2}\left( {{{{\mathbf{x}}}}_k;\phi _k} \right)} \right)} \end{array} $$
(13)
其中 ϕ k 是 第 k 个组学层的多层感知器编码器中可学习参数的集合。
然后可以通过最大化以下证据下限来进行模型拟合:
$\sum_{k = 1}^{K} \mathbb{E}{\mathbf{x}{k} sim p_{d a t a} \left(\right. \mathbf{x}{k} \left.\right)} \left[\right. \begin{matrix}\mathbb{E}{\mathbf{u} sim q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} ; \phi{k} \left.\right) , \mathbf{V} sim q \left(\right. \mathbf{V} \left|\right. \mathcal{G} ; \phi_{\mathcal{G}} \left.\right)} log p \left(\right. \mathbf{x}{k} \left|\right. \mathbf{u} , \mathbf{V} ; \theta{k} \left.\right) p \left(\right. \mathcal{G} \left|\right. \mathbf{V} ; \theta_{\mathcal{G}} \left.\right) \ - K L \left(\right. q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} ; \phi{k} \left.\right) q \left(\right. \mathbf{V} \left|\right. \mathcal{G} ; \phi_{\mathcal{G}} \left.\right) \parallel p \left(\right. \mathbf{u} \left.\right) p \left(\right. \mathbf{V} \left.\right) \left.\right)\end{matrix} \left]\right.$ $$ \begin{array}{{20}{c}} {\mathop {\sum}\limits_{k = 1}^K {{\Bbb E}_{{{{\mathbf{x}}}}k \sim p{{{{\mathrm{data}}}}}\left( {{{{\mathbf{x}}}}_k} \right)}} \left[ {\begin{array}{{20}{c}} {{\Bbb E}_{{{{\mathbf{u}}}} \sim q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k;\phi _k} \right),{{{\mathbf{V}}}} \sim q\left( {{{{\mathbf{V}}}}|{{{\mathcal{G}}}};\phi _{{{\mathcal{G}}}}} \right)}\log p\left( {{{{\mathbf{x}}}}_k|{{{\mathbf{u}}}},{{{\mathbf{V}}}};\theta _k} \right)p\left( {{{{\mathcal{G}}}}|{{{\mathbf{V}}}};\theta _{{{\mathcal{G}}}}} \right)} \ { - \mathrm{KL}\left( {q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k;\phi _k} \right)q\left( {{{{\mathbf{V}}}}|{{{\mathcal{G}}}};\phi _{{{\mathcal{G}}}}} \right)\parallel p\left( {{{\mathbf{u}}}} \right)p\left( {{{\mathbf{V}}}} \right)} \right)} \end{array}} \right]} \end{array} $$
(14)
它可以进一步重新排列成以下形式:
$K \cdot \mathcal{L}{\mathcal{G}} \left(\right. \theta{\mathcal{G}} , \phi_{\mathcal{G}} \left.\right) + \sum_{k = 1}^{K} \mathcal{L}{\mathcal{X}{k}} \left(\right. \theta_{k} , \phi_{k} , \phi_{\mathcal{G}} \left.\right)$ $$ \begin{array}{*{20}{c}} {K \cdot {{{\mathcal{L}}}}_{{{\mathcal{G}}}}\left( {\theta {{{\mathcal{G}}}},\phi {{{\mathcal{G}}}}} \right) + \mathop {\sum}\limits{k = 1}^K {{{{\mathcal{L}}}}{{{{\mathcal{X}}}}_k}} \left( {\theta _k,\phi _k,\phi _{{{\mathcal{G}}}}} \right)} \end{array} $$
(15)
我们有
$\mathcal{L}{\mathcal{X}{k}} \left(\right. \theta_{k} , \phi_{k} , \phi_{\mathcal{G}} \left.\right) = \mathbb{E}{\mathbf{x}{k} sim p_{d a t a} \left(\right. \mathbf{x}{k} \left.\right)} \ \left[\right. \mathbb{E}{\mathbf{u} sim q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} ; \phi{k} \left.\right) , \mathbf{V} sim q \left(\right. \mathbf{V} \left|\right. \mathcal{G} ; \phi_{\mathcal{G}} \left.\right)} log p \left(\right. \mathbf{x}{k} \left|\right. \mathbf{u} , \mathbf{V} ; \theta{k} \left.\right) - K L \left(\right. q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} ; \phi{k} \left.\right) \parallel p \left(\right. \mathbf{u} \left.\right) \left.\right) \left]\right.$ $$ \begin{array}{rcl}{{{\mathcal{L}}}}_{{{{\mathcal{X}}}}_k}\left( {\theta _k,\phi _k,\phi {{{\mathcal{G}}}}} \right) = {\Bbb E}{{{{\mathbf{x}}}}k \sim p{{{{\mathrm{data}}}}}\left( {{{{\mathbf{x}}}}k} \right)} \ \left[ {{\Bbb E}{{{{\mathbf{u}}}} \sim q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k;\phi _k} \right),{{{\mathbf{V}}}} \sim q\left( {{{{\mathbf{V}}}}|{{{\mathcal{G}}}};\phi _{{{\mathcal{G}}}}} \right)}\log p\left( {{{{\mathbf{x}}}}_k|{{{\mathbf{u}}}},{{{\mathbf{V}}}};\theta _k} \right) - {{{\mathrm{KL}}}}\left( {q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k;\phi _k} \right)\parallel p\left( {{{\mathbf{u}}}} \right)} \right)} \right]\end{array} $$
(16)
$\mathcal{L}{\mathcal{G}} \left(\right. \theta{\mathcal{G}} , \phi_{\mathcal{G}} \left.\right) = \mathbb{E}{\mathbf{V} sim q \left(\right. \mathbf{V} \left|\right. \mathcal{G} ; \phi{\mathcal{G}} \left.\right)} log p \left(\right. \mathcal{G} \left|\right. \mathbf{V} ; \theta_{\mathcal{G}} \left.\right) - K L \left(\right. q \left(\right. \mathbf{V} \left|\right. \mathcal{G} ; \phi_{\mathcal{G}} \left.\right) \parallel p \left(\right. \mathbf{V} \left.\right) \left.\right)$ $$ \begin{array}{*{20}{c}} {{{{\mathcal{L}}}}_{{{\mathcal{G}}}}\left( {\theta _{{{\mathcal{G}}}},\phi {{{\mathcal{G}}}}} \right) = {\Bbb E}{{{{\mathbf{V}}}} \sim q\left( {{{{\mathbf{V}}}}|{{{\mathcal{G}}}};\phi _{{{\mathcal{G}}}}} \right)}\log p\left( {{{{\mathcal{G}}}}|{{{\mathbf{V}}}};\theta _{{{\mathcal{G}}}}} \right) - \mathrm{KL}\left( {q\left( {{{{\mathbf{V}}}}|{{{\mathcal{G}}}};\phi _{{{\mathcal{G}}}}} \right)\parallel p\left( {{{\mathbf{V}}}} \right)} \right)} \end{array} $$
(17)
为方便起见,下面我们将所有编码器参数的并集表示为 $\phi = \left(\right. \cup_{k = 1}^{K} \phi_{k} \left.\right) \cup \phi_{\mathcal{G}}$ ,将所有解码器参数的并集表示为 $\theta = \left(\right. \cup_{k = 1}^{K} \theta_{k} \left.\right) \cup \theta_{\mathcal{G}}$ 。
为了确保不同组学层之间的正确对齐,我们采用了对抗对齐策略 [^31] [^71] 。引入了一个具有 K 维 softmax 输出的判别器 D,它基于细胞的嵌入向量 u 来预测细胞的组学层。判别器 D 通过最小化多类分类交叉熵进行训练:
$\mathcal{L}{D} \left(\right. \phi , \psi \left.\right) = - \frac{1}{K} \sum{k = 1}^{K} \mathbb{E}{\mathbf{x}{k} sim p_{d a t a} \left(\right. \mathbf{x}{k} \left.\right)} \mathbb{E}{\mathbf{u} sim q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} ; \phi{k} \left.\right)} log D_{k} \left(\right. \mathbf{u} ; \psi \left.\right)$ $$ \begin{array}{*{20}{c}} {{{{\mathcal{L}}}}{{{\mathrm{D}}}}\left( {\phi ,\psi } \right) = - \frac{1}{K}\mathop {\sum }\limits{k = 1}^K {\Bbb E}_{{{{\mathbf{x}}}}k \sim p{{{{\mathrm{data}}}}}\left( {{{{\mathbf{x}}}}k} \right)}{\Bbb E}{{{{\mathbf{u}}}} \sim q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k;\phi _k} \right)}\log {{{\mathrm{D}}}}_k\left( {{{{\mathbf{u}}}};\psi } \right)} \end{array} $$
(18)
其中 D k 表示判别器输出的第 k 个维度, ψ 是判别器中可学习参数的集合。然后可以反向训练数据编码器来欺骗判别器,最终实现来自不同组学层的细胞嵌入的对齐 [^72] 。
因此,GLUE 的总体培训目标包括:
$\underset{\psi}{min} \lambda_{D} \cdot \mathcal{L}{D} \left(\right. \phi , \psi \left.\right)$ $$ \begin{array}{*{20}{c}} {\mathop {{\min }}\limits\psi \lambda {{{\mathrm{D}}}} \cdot {{{\mathcal{L}}}}{{{\mathrm{D}}}}\left( {\phi ,\psi } \right)} \end{array} $$
(19)
$\underset{\theta , \phi}{max} \lambda_{D} \cdot \mathcal{L}{D} \left(\right. \phi , \psi \left.\right) + \lambda{\mathcal{G}} K \cdot \mathcal{L}{\mathcal{G}} \left(\right. \theta{\mathcal{G}} , \phi_{\mathcal{G}} \left.\right) + \sum_{k = 1}^{K} \mathcal{L}{\mathcal{X}{k}} \left(\right. \theta_{k} , \phi_{k} , \phi_{\mathcal{G}} \left.\right)$ $$ \begin{array}{*{20}{c}} {\mathop {{\max }}\limits_{\theta ,\phi } \lambda {{{\mathrm{D}}}} \cdot {{{\mathcal{L}}}}{{{\mathrm{D}}}}\left( {\phi ,\psi } \right) + \lambda {{{\mathcal{G}}}}K \cdot {{{\mathcal{L}}}}{{{\mathcal{G}}}}\left( {\theta {{{\mathcal{G}}}},\phi {{{\mathcal{G}}}}} \right) + \mathop {\sum }\limits{k = 1}^K {{{\mathcal{L}}}}{{{{\mathcal{X}}}}_k}\left( {\theta _k,\phi _k,\phi _{{{\mathcal{G}}}}} \right)} \end{array} $$
(20)
两个超参数 λ D 和 $\lambda_{\mathcal{G}}$ 分别控制对抗对齐和基于图的特征嵌入的贡献。我们使用随机梯度下降法训练 GLUE 模型。每次随机梯度下降迭代分为两个步骤。第一步,根据目标函数( 19 )更新判别器。第二步,根据目标函数( 20 )更新数据自编码器和图自编码器。为了保证对抗训练的稳定性,我们使用不带动量项的 RMSprop 优化器。
加权对抗对齐#
如先前的工作 [^31] 所示,规范对抗比对相当于最小化不同组学层细胞嵌入分布之间的广义 Jensen-Shannon 散度:
$\frac{1}{K} \sum_{k = 1}^{K} K L \left(\right. q_{k} \left(\right. \mathbf{u} \left.\right) \left|\right. \left|\right. \frac{1}{K} \sum_{k = 1}^{K} q_{k} \left(\right. \mathbf{u} \left.\right) \left.\right)$ $$ \frac{1}{K}\mathop {\sum}\limits_{k = 1}^K {{{{\mathrm{KL}}}}} \left( {q_k({{{\mathbf{u}}}})||\frac{1}{K}\mathop {\sum}\limits_{k = 1}^K {q_k} ({{{\mathbf{u}}}})} \right) $$
(21)
其中 $q_{k} \left(\right. \mathbf{u} \left.\right) = \mathbb{E}{\mathbf{x}{k} sim p_{d a t a} \left(\right. \mathbf{x}{k} \left.\right)} q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k} ; \phi_{k} \left.\right)$ 表示 第 k 层的边缘细胞嵌入分布。在没有其他损失项的情况下,方程 ( 21 ) 在完美对齐时收敛,即当 $q_{i} \left(\right. \mathbf{u} \left.\right) = q_{j} \left(\right. \mathbf{u} \left.\right) , \forall i \neq j$ 时。当不同层之间的细胞类型组成差异很大时,例如在细胞图谱整合中,这可能会出现问题。为了解决这个问题,我们在方程 ( 18 ) 的判别器损失中添加了细胞特异性权重 w (n) :
$\mathcal{L}{D} \left(\right. \phi , \psi \left.\right) = - \frac{1}{K} \sum{k = 1}^{K} \frac{1}{W_{k}} \sum_{n = 1}^{N_{k}} w^{\left(\right. n \left.\right)} \cdot \mathbb{E}{\mathbf{u} sim q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k}^{\left(\right. n \left.\right)} ; \phi_{k} \left.\right)} log D_{k} \left(\right. \mathbf{u} ; \psi \left.\right)$ $$ \begin{array}{*{20}{c}} {{{{\mathcal{L}}}}{{{\mathrm{D}}}}\left( {\phi ,\psi } \right) = - \frac{1}{K}\mathop {\sum }\limits{k = 1}^K \frac{1}{{W_k}}\mathop {\sum }\limits_{n = 1}^{N_k} w^{\left( n \right)} \cdot {\Bbb E}_{{{{\mathbf{u}}}} \sim q\left( {{{{\mathbf{u}}}}|{{{\mathbf{x}}}}_k^{\left( n \right)};\phi _k} \right)}\log {{{\mathrm{D}}}}_k\left( {{{{\mathbf{u}}}};\psi } \right)} \end{array} $$
(22)
其中归一化器为 $W_{k} = \sum_{n = 1}^{N_{k}} w^{\left(\right. n \left.\right)}$ 。对抗性对齐仍然相当于最小化方程( 21 ),但使用加权边缘单元嵌入分布 $q_{k} \left(\right. \mathbf{u} \left.\right) = \frac{1}{W_{k}} \sum_{n = 1}^{N_{k}} w^{\left(\right. n \left.\right)} q \left(\right. \mathbf{u} \left|\right. \mathbf{x}{k}^{\left(\right. n \left.\right)} ; \phi{k} \left.\right)$ 。通过分配适当的权重来平衡不同层之间的单元分布, $q_{i} \left(\right. \mathbf{u} \left.\right) = q_{j} \left(\right. \mathbf{u} \left.\right) , \forall i \neq j$ 的最优值可以更接近所需的对齐方式。
为了以无监督的方式获得平衡权重,我们设计了以下两阶段训练流程。首先,我们使用恒定权重 $w^{\left(\right. n \left.\right)} = 1$ 预训练 GLUE 模型,在此过程中,我们在将细胞嵌入传递给判别器之前,向细胞嵌入中添加噪声 $\mathbf{\mathit{\epsilon}} sim \mathcal{N} \left(\right. \mathbf{\mathit{\epsilon}} ; 0 , \Sigma \left.\right)$ 。我们将 ∑ 设置为每个小批量中细胞嵌入经验方差的 1.5 倍,这有助于生成一个对成分不平衡不敏感的粗略比对。然后,我们使用 Leiden 聚类对每个组学层的粗略比对的细胞嵌入进行聚类。第 i 个簇中细胞的平衡权重 w 计算如下:
$w_{i} = \frac{\sum_{k_{i} \neq k_{j}} f \left(\right. \mathbf{u}{i} , \mathbf{u}{j} \left.\right)}{n_{i}}$ $$ \begin{array}{*{20}{c}} {w_i = \frac{{\mathop {\sum }\nolimits_{k_i \ne k_j} f\left( {{{{\mathbf{u}}}}_i,{{{\mathbf{u}}}}_j} \right)}}{{n_i}}} \end{array} $$
(23)
$f \left(\right. \mathbf{u}{i} , \mathbf{u}{j} \left.\right) = \left{\right. \begin{matrix}cos \left(\left(\right. \mathbf{u}{i} , \mathbf{u}{j} \left.\right)\right)^{4} , & c o s \left(\right. \mathbf{u}{i} , \mathbf{u}{j} \left.\right) > 0.5 \ 0 , & o t h e r w i s e\end{matrix}$ $$ \begin{array}{{20}{c}} {f\left( {{{{\mathbf{u}}}}_i,{{{\mathbf{u}}}}_j} \right) = \left{ {\begin{array}{{20}{l}} {\cos \left( {{{{\mathbf{u}}}}_i,{{{\mathbf{u}}}}_j} \right)^4,} \hfill & {{\mathrm{cos}}({{{\mathbf{u}}}}_i,{{{\mathbf{u}}}}_j) > 0.5} \hfill \ {0,} \hfill & {{\mathrm{otherwise}}} \hfill \end{array}} \right.} \end{array} $$
(24)
其中, u 是簇 i 的平均细胞嵌入, k 表示簇 i 的组学层, n 是簇 i 中的细胞数量。换句话说,我们将簇 i 与其在其他层中所有余弦相似度为 3E0.5 的匹配簇之间的余弦相似度(取 4 次方以增加对比度)相加,然后按簇大小进行归一化,从而有效地平衡了匹配簇的贡献,而与它们的大小无关。在第二阶段,我们使用估计的平衡权重对 GLUE 模型进行微调,在此过程中,加性噪声 $\mathbf{\mathit{\epsilon}} sim \mathcal{N} \left(\right. \mathbf{\mathit{\epsilon}} ; 0 , \tau \cdot \Sigma \left.\right)$ 逐渐退火至 0( τ 从 1 开始,并在每个 epoch 中线性递减直至 0)。退火 epoch 数根据数据大小和学习率自动设置,以匹配学习率 0.002 时相当于 4000 次迭代的学习进度。
本研究中的所有基准测试和案例研究均采用上述两阶段训练程序进行,无论所使用的数据集是否平衡。
批次效应校正#
为了处理组学层中的批次效应,我们将批次作为协变量纳入数据解码器。假设 $b \in \left{\right. 1 , 2 , \ldots , B \left.\right}$ 为批次索引,其中 B 为批次总数,则解码器似然函数扩展到 $p \left(\right. \mathbf{x}{k} \left|\right. \mathbf{u} , \mathbf{V} , b ; \theta{k} \left.\right)$ 。具体而言,这是通过将数据解码器中的可学习参数转换为批次相关的参数来实现的。例如,对于负二项式解码器,网络现在使用批次特定的 α 、 β 和 θ 参数:
$p \left(\right. \mathbf{x}{k} \left|\right. \mathbf{u} , \mathbf{V} , b ; \theta{k} \left.\right) = \underset{i \in \mathcal{V}{k}}{\prod} N B \left(\right. \mathbf{x}{k}{i} ; \mu{i} , \theta_{b}{i} \left.\right)$ $$ \begin{array}{*{20}{c}} {p\left( {{{{\mathbf{x}}}}k|{{{\mathbf{u}}}},{{{\mathbf{V}}}},b;\theta k} \right) = \mathop {\prod }\limits{i \in {{{\mathcal{V}}}}k} {{{\mathrm{NB}}}}\left( {{\mathbf{x}{k}}{i};{{{\mathbf{\mu }}}}i,{\mathbf{\theta }{b}}{i}} \right)} \end{array} $$
(25)
$N B \left(\right. \mathbf{x}{k}{i} ; \mu_{i} , \theta_{b}{i} \left.\right) = \frac{\Gamma \left(\right. \mathbf{x}{k}{i} + \theta{b}{i} \left.\right)}{\Gamma \left(\right. \theta{b}{i} \left.\right) \Gamma \left(\right. \mathbf{x}{k}{i} + 1 \left.\right)} \left(\left(\right. \frac{\mu{i}}{\theta_{b}{i} + \mu{i}} \left.\right)\right)^{\mathbf{x}{k}{i}} \left(\left(\right. \frac{\theta_{b}{i}}{\theta{b}{i} + \mu{i}} \left.\right)\right)^{\theta_{b}{i}}$ $$ \begin{array}{*{20}{c}} {{\mathrm{NB}}\left( {{\mathbf{x}{k}}{i};{{{\mathbf{\mu }}}}i,{\mathbf{\theta }{b}}{i}} \right) = \frac{{{\Gamma}\left( {{\mathbf{x}{k}}{i} + {\mathbf{\theta }{b}}{i}} \right)}}{{{\Gamma}\left( {{\mathbf{\theta }{b}}{i}} \right){\Gamma}\left( {{\mathbf{x}{k}}{i} + 1} \right)}}\left( {\frac{{{{{\mathbf{\mu }}}}i}}{{{\mathbf{\theta }{b}}{i} + {{{\mathbf{\mu }}}}i}}} \right)^{{\mathbf{x}{k}}{i}}\left( {\frac{{{\mathbf{\theta }{b}}{i}}}{{{\mathbf{\theta }{b}}{i} + {{{\mathbf{\mu }}}}i}}} \right)^{{\mathbf{\theta }{b}}_{i}}} \end{array} $$
(26)
$\mu_{i} = S o f t m a x_{i} \left(\right. \alpha_{b} \bigodot \mathbf{V}{k}^{\top} \mathbf{u} + \beta{b} \left.\right) \cdot \underset{j \in \mathcal{V}{k}}{\sum} \mathbf{x}{k}_{j}$ $$ \begin{array}{*{20}{c}} {{{{\mathbf{\mu }}}}_i = {{{\mathrm{Softmax}}}}_i\left( {{{{\mathbf{\alpha }}}}_b \odot {{{\mathbf{V}}}}k^ \top {{{\mathbf{u}}}} + {{{\mathbf{\beta }}}}b} \right) \cdot \mathop {\sum }\limits{j \in {{{\mathcal{V}}}}k} {\mathbf{x}{k}}{j}} \end{array} $$
(27)
其中 $\alpha \in \mathbb{R}{+}^{B \times \left|\right. \mathcal{V}{k} \left|\right.} , \beta \in \mathbb{R}^{B \times \left|\right. \mathcal{V}{k} \left|\right.} , \theta \in \mathbb{R}{+}^{B \times \left|\right. \mathcal{V}_{k} \left|\right.}$ , α b , β b , θ b 分别是 α 、 β 、 θ 的第 b 行。其他概率解码器也可以用类似的方式扩展。
实施细节#
我们采用线性降维方法,例如主成分分析(PCA,用于单细胞 RNA 测序)或潜在语义索引(LSI,用于单细胞 ATAC 测序),作为数据编码器的第一层转换层(注意解码器仍然在原始特征空间中拟合)。这有效地减小了模型规模并实现了模块化输入,因此也可以使用更高级的降维方法或批次效应校正方法作为 GLUE 集成的预处理步骤。
在模型训练过程中,10% 的单元格被用作验证集。在训练的最后阶段,如果验证损失连续几个 epoch 没有改善,则学习率将降低 10 倍。如果验证损失仍然连续几个 epoch 没有改善,则训练终止。学习率降低的耐心值、训练终止的阈值以及最大训练 epoch 数均根据数据规模和学习率自动设置,以分别对应于学习率为 0.002 时 1000 次、2000 次和 16000 次迭代的学习进度。
除非另有明确说明,所有使用 GLUE 进行的基准测试和案例研究均采用默认超参数。默认超参数集见扩展数据图 3 。
整合一致性评分#
整合一致性评分衡量的是整合的多组学数据与指导图之间的一致性。首先,我们使用 k 均值聚类算法在对齐的细胞嵌入空间中对所有组学层中的细胞进行联合聚类。对于每个组学层,每个聚类中的细胞被聚合为一个元细胞。这些元细胞被建立为配对样本,基于此可以计算特征相关性。然后,我们利用这些配对的元细胞计算指导图中每条边的 Spearman 相关系数。整合一致性评分定义为所有图边的平均相关系数,并根据边的符号取反,最后根据边的权重进行加权。
系统性基准#
UnionCom [^23] 、Pamona [^24] 和 GLUE 分别使用 Python 包 'unioncom' (v.0.3.0)、'Pamona' (v.0.1.0) 和 'scglue' (v.0.2.0) 执行。MMD-MA [^25] 使用 https://bitbucket.org/noblelab/2020_mmdma_pytorch 提供的 Python 脚本执行。Online iNMF [^16] 、LIGER [^17] 、Harmony [^18] 、bindSC [^33] 和 Seurat v3 (ref. [^15] ) 分别使用 R 包 'rliger' (v.1.0.0)、'rliger' (v.1.0.0)、'harmony' (v.0.1.0)、'bindSC' (v.1.0.0) 和 'Seurat' (v.4.0.2) 执行。对于每种方法,我们都使用了推荐的默认超参数设置和数据预处理步骤。对于单细胞 RNA 测序(scRNA-seq)数据,我们使用 Seurat 的“vst”方法筛选了 2000 个高变异基因。我们采用了两种不同的方案来构建引导图。在标准方案中,如果 ATAC 峰与 RNA 基因在基因体或近端启动子区域(定义为转录起始位点上游 2 kb)重叠,则通过正边将它们连接起来。在另一种方案中,我们使用了更大的基因组窗口,如果 ATAC 峰位于近端基因启动子 150 kb 范围内,则通过正边将它们连接起来;边的权重由幂律函数 $w = \left(\left(\right. d + 1 \left.\right)\right)^{- 0.75}$ ( d 为基因组距离,单位为 kb)决定,该函数已被用于模拟染色质接触的概率 [^42] [^43] 。对于需要特征转换的方法(在线 iNMF、LIGER、bindSC 和 Seurat v.3),我们通过将指导图中与特定基因相连的 ATAC 峰的计数相加,将 scATAC-seq 数据转换为基因水平的活性得分。 值得注意的是,在线 iNMF 和 LIGER 也推荐了一种替代的 ATAC 特征转换方法,即直接计数位于基因体和启动子区域的 ATAC 片段,而无需借助 ATAC 峰( https://htmlpreview.github.io/? https://github.com/welch-lab/liger/blob/master/vignettes/Integrating_scRNA_and_scATAC_data.html ),我们将其简称为 FiG(基因片段)。我们也尽可能地使用在线 iNMF 和 LIGER 对 FiG 特征转换方法进行了测试。
采用平均精度均值(MAP)来评估细胞类型分辨率。假设 第 i 个细胞的类型为 y (i) ,其 K 个有序最近邻细胞的类型分别为 $y_{1}^{\left(\right. i \left.\right)} , y_{2}^{\left(\right. i \left.\right)} , \ldots , y_{K}^{\left(\right. i \left.\right)}$ ,则平均精度均值定义如下:
$M A P = \frac{1}{N} \sum_{i = 1}^{N} A P^{\left(\right. i \left.\right)}$ $$ \begin{array}{*{20}{c}} {{\mathrm{MAP}} = \frac{1}{N}\mathop {\sum}\limits_{i = 1}^N {{{{\mathrm{AP}}}}^{\left( i \right)}} } \end{array} $$
(28)
$A P^{\left(\right. i \left.\right)} = \left{\right. \begin{matrix}\frac{\sum_{k = 1}^{K} 1_{y^{\left(\right. i \left.\right)} = y_{k}} \cdot \frac{\sum_{j = 1}^{k} 1_{y^{\left(\right. i \left.\right)} = y_{j}^{\left(\right. i \left.\right)}}}{k}}{\sum_{k = 1}^{K} 1_{y^{\left(\right. i \left.\right)} = y_{k}^{\left(\right. i \left.\right)}}} , & i f \sum_{k = 1}^{K} 1_{y^{\left(\right. i \left.\right)} = y_{k}^{\left(\right. i \left.\right)}} > 0 \ 0 , & o t h e r w i s e\end{matrix}$ $$ \begin{array}{{20}{c}} {{{{\mathrm{AP}}}}^{\left( i \right)} = \left{ {\begin{array}{{20}{l}} {\frac{{\mathop {\sum }\nolimits_{k = 1}^K 1_{y^{\left( i \right)} = y_k} \cdot \frac{{\mathop {\sum }\nolimits_{j = 1}^k 1_{y^{\left( i \right)} = y_j^{\left( i \right)}}}}{k}}}{{\mathop {\sum }\nolimits_{k = 1}^K 1_{y^{\left( i \right)} = y_k^{\left( i \right)}}}},} \hfill & {{\mathrm{if}},\mathop {\sum }\limits_{k = 1}^K 1_{y^{\left( i \right)} = y_k^{\left( i \right)}} > 0} \hfill \ {0,} \hfill & {{\mathrm{otherwise}}} \hfill \end{array}} \right.} \end{array} $$
(29)
其中 $1_{y^{\left(\right. i \left.\right)} = y_{k}^{\left(\right. i \left.\right)}}$ 是一个指示函数,当 $y^{\left(\right. i \left.\right)} = y_{k}^{\left(\right. i \left.\right)}$ 时取值为 1,否则为 0。对于每个单元格,平均精度 (AP) 计算其与相邻单元格类型匹配的平均精度,平均精度均值 (MAP) 则计算所有单元格的平均精度均值。我们将 K 设置为每个数据集中单元格总数的 1%。平均精度均值 (MAP) 的取值范围为 0 到 1,值越高表示单元格类型分辨率越高。
单元类型 ASW(平均轮廓宽度)也被用于评估单元类型分辨率,其定义与最近的基准研究 [^73] 中的定义相同:
$c e l l t y p e A S W = \frac{1}{2} \left(\right. \frac{\sum_{i = 1}^{N} s_{c e l l t y p e}^{\left(\right. i \left.\right)}}{N} + 1 \left.\right)$ $$ \begin{array}{*{20}{c}} {{\mathrm{cell}},{\mathrm{type}},{\mathrm{ASW}} = \frac{1}{2}\left( {\frac{{\mathop {\sum }\nolimits_{i = 1}^N s_{{{{\mathrm{cell}}}},{{{\mathrm{type}}}}}^{\left( i \right)}}}{N} + 1} \right)} \end{array} $$
(30)
其中 $s_{c e l l t y p e}^{\left(\right. i \left.\right)}$ 表示 第 i 个单元格的单元格类型轮廓宽度, N 为单元格总数。单元格类型 ASW 的取值范围为 0 到 1,值越高表示单元格类型分辨率越高。
邻域一致性(NC)用于评估多组学整合后单组学数据变异的保留情况,其定义遵循先前的研究 [^74] :
$N C = \frac{1}{N} \sum_{i = 1}^{N} \frac{\left|\right. N N S^{\left(\right. i \left.\right)} \cap N N I^{\left(\right. i \left.\right)} \left|\right.}{\left|\right. N N S^{\left(\right. i \left.\right)} \cup N N I^{\left(\right. i \left.\right)} \left|\right.}$ $$ \begin{array}{*{20}{c}} {{\mathrm{NC}} = \frac{1}{N}\mathop {\sum }\limits_{i = 1}^N \frac{{\left| {{{{\mathrm{NNS}}}}^{\left( {{{\mathrm{i}}}} \right)} \cap {{{\mathrm{NNI}}}}^{\left( {{{\mathrm{i}}}} \right)}} \right|}}{{\left| {{{{\mathrm{NNS}}}}^{\left( {{{\mathrm{i}}}} \right)} \cup {{{\mathrm{NNI}}}}^{\left( {{{\mathrm{i}}}} \right)}} \right|}}} \end{array} $$
(31)
其中,NNS (i) 表示单组学数据中细胞 i 的 k 近邻集合,NNI (i) 表示整合空间中 第 i 个细胞的 K 近邻集合, N 表示细胞总数。我们在每个数据集中将 K 设置为细胞总数的 1%。邻域一致性取值范围为 0 到 1,值越高表示数据变异的保留程度越好。
生物学保护
平均精度均值、细胞类型 ASW 和邻域一致性均用于衡量数据整合的生物学保守性。参照近期基准研究 [^73] 的方法,我们首先对每个指标进行最小-最大缩放,然后计算三个指标的平均值,将它们汇总为一个代表生物学保守性的单一指标:
$b i o l o g y c o n s e r v a t i o n = \frac{s c a l e \left(\right. M A P \left.\right) + s c a l e \left(\right. c e l l t y p e A S W \left.\right) + s c a l e \left(\right. N C \left.\right)}{3}$ $$ \begin{array}{*{20}{c}} {{\mathrm{biology}},{\mathrm{conservation}} = \frac{{{{{\mathrm{scale}}}}\left( {{{{\mathrm{MAP}}}}} \right) + {{{\mathrm{scale}}}}\left( {{{{\mathrm{cell}}}},{{{\mathrm{type}}}},{{{\mathrm{ASW}}}}} \right) + {{{\mathrm{scale}}}}\left( {{{{\mathrm{NC}}}}} \right)}}{3}} \end{array} $$
(32)
Seurat 比对分数 (SAS) 用于评估组学层之间的混合程度,其计算方法如原始论文 [^75] 中所述:
$S A S = 1 - \frac{\bar{x} - \frac{K}{N}}{K - \frac{K}{N}}$ $$ \begin{array}{*{20}{c}} {{\mathrm{SAS}} = 1 - \frac{{\bar x - \frac{K}{N}}}{{K - \frac{K}{N}}}} \end{array} $$
(33)
其中, $\bar{x}$ 表示来自同一组学层的 K 个最近邻细胞的平均数量(不同层首先被下采样至与最小层相同的细胞数量), N 为组学层的数量。我们将 K 设置为下采样细胞数量的 1%。Seurat 比对得分的范围为 0 到 1,值越高表示混合效果越好。
组学层 ASW 也被用于评估组学层之间的混合程度,其定义与最近的基准研究 [^73] 中的定义相同:
$o m i c s l a y e r A S W = \frac{1}{M} \sum_{j = 1}^{M} o m i c s l a y e r A S W_{j}$ $$ \begin{array}{*{20}{c}} {{\mathrm{omics}},{\mathrm{layer}},{\mathrm{ASW}} = \frac{1}{M}\mathop {\sum}\limits_{j = 1}^M {{{{\mathrm{omics}}}},{{{\mathrm{layer}}}},{{{\mathrm{ASW}}}}_{{{\mathrm{j}}}}} } \end{array} $$
(34)
$o m i c s l a y e r A S W_{j} = \frac{1}{N_{j}} \sum_{i = 1}^{N_{j}} 1 - \left|\right. s_{o m i c s l a y e r}^{\left(\right. i \left.\right)} \left|\right.$ $$ \begin{array}{*{20}{c}} {{{{\mathrm{omics}}}},{{{\mathrm{layer}}}},{{{\mathrm{ASW}}}}{{{\mathrm{j}}}} = \frac{1}{{N_j}}\mathop {\sum }\limits{i = 1}^{N_j} 1 - \left| {s_{{{{\mathrm{omics}}}},{{{\mathrm{layer}}}}}^{\left( i \right)}} \right|} \end{array} $$
(35)
其中 , $s_{o m i c s l a y e r}^{\left(\right. i \left.\right)}$ 表示 第 i 个细胞的组学层轮廓宽度, N 表示细胞类型 j 的细胞数量, M 表示细胞类型的总数。组学层 ASW 的取值范围为 0 到 1,值越高表示混合效果越好。
图连通性(GC)也被用于评估组学层之间的混合程度,其定义与最近的基准研究 [^73] 中的定义相同:
$G C = \frac{1}{M} \sum_{j = 1}^{M} \frac{\left|\right. L C C_{j} \left|\right.}{N_{j}}$ $$ \begin{array}{*{20}{c}} {{\mathrm{GC}} = \frac{1}{M}\mathop {\sum }\limits_{j = 1}^M \frac{{\left| {{{{\mathrm{LCC}}}}_j} \right|}}{{N_j}}} \end{array} $$
(36)
其中,LCC 表示细胞类型 j 的 k 近邻图( K = 15)中最大连通分量内的细胞数量, N 表示细胞类型 j 的细胞数量, M 表示细胞类型的总数。图连通性的取值范围为 0 到 1,值越高表示混合程度越好。
组学混合
Seurat 比对得分、组学层 ASW 和图连通性均用于衡量数据整合中的组学混合程度。参照近期基准研究 [^73] 的方法,我们首先对每个指标进行最小-最大缩放,然后计算三个指标的平均值,将它们汇总为一个代表组学混合程度的单一指标:
$o m i c s m i x i n g = \frac{s c a l e \left(\right. S A S \left.\right) + s c a l e \left(\right. o m i c s l a y e r A S W \left.\right) + s c a l e \left(\right. G C \left.\right)}{3}$ $$ \begin{array}{*{20}{c}} {{\mathrm{omics}},{\mathrm{mixing}} = \frac{{{{{\mathrm{scale}}}}\left( {{{{\mathrm{SAS}}}}} \right) + {{{\mathrm{scale}}}}\left( {{{{\mathrm{omics}}}},{{{\mathrm{layer}}}},{{{\mathrm{ASW}}}}} \right) + {{{\mathrm{scale}}}}\left( {{{{\mathrm{GC}}}}} \right)}}{3}} \end{array} $$
(37)
总体整合得分
为了计算总体整合得分,我们采用生物学保守性和组学混合性之间的 6:4 权重,遵循最近的基准研究 [^73] :
$o v e r a l l i n t e g r a t i o n s c o r e = 0.6 \times b i o l o g y c o n s e r v a t i o n + 0.4 \times o m i c s m i x i n g$ $$ \begin{array}{*{20}{c}} {{\mathrm{overall}},{\mathrm{integration}},{\mathrm{score}} = 0.6 \times {\mathrm{biology}},{\mathrm{conservation}} + 0.4 \times {\mathrm{omics}},{\mathrm{mixing}}} \end{array} $$
(38)
FOSCTTM [^25] 用于评估单细胞水平比对的准确率。它在两个已知细胞间配对的数据集上进行计算。假设每个数据集包含 N 个 细胞,并且这些细胞按相同顺序排序,即第一个数据集中的第 i 个细胞与第二个数据集中的第 i 个细胞配对。分别用 x 和 y 表示第一个和第二个数据集的细胞嵌入。FOSCTTM 定义如下:
$F O S C T T M = \frac{1}{2 N} \left(\right. \sum_{i = 1}^{N} \frac{n_{1}^{\left(\right. i \left.\right)}}{N} + \sum_{i = 1}^{N} \frac{n_{2}^{\left(\right. i \left.\right)}}{N} \left.\right)$ $$ \begin{array}{*{20}{c}} {{\mathrm{FOSCTTM}} = \frac{1}{{2N}}\left( {\mathop {\sum }\limits_{i = 1}^N \frac{{n_1^{\left( i \right)}}}{N} + \mathop {\sum }\limits_{i = 1}^N \frac{{n_2^{\left( i \right)}}}{N}} \right)} \end{array} $$
(39)
$n_{1}^{\left(\right. i \left.\right)} = \left|\right. \left{\right. j \left|\right. d \left(\right. \mathbf{x}{j} , \mathbf{y}{i} \left.\right) < d \left(\right. \mathbf{x}{i} , \mathbf{y}{i} \left.\right) \left.\right} \left|\right.$ $$ \begin{array}{*{20}{c}} {n_1^{\left( i \right)} = \left| {\left{ {j|d\left( {{{{\mathbf{x}}}}_j,{{{\mathbf{y}}}}_i} \right) < d\left( {{{{\mathbf{x}}}}_i,{{{\mathbf{y}}}}_i} \right)} \right}} \right|} \end{array} $$
(40)
$n_{2}^{\left(\right. i \left.\right)} = \left|\right. \left{\right. j \left|\right. d \left(\right. \mathbf{x}{i} , \mathbf{y}{j} \left.\right) < d \left(\right. \mathbf{x}{i} , \mathbf{y}{i} \left.\right) \left.\right} \left|\right.$ $$ \begin{array}{*{20}{c}} {n_2^{\left( i \right)} = \left| {\left{ {j|d\left( {{{{\mathbf{x}}}}_i,{{{\mathbf{y}}}}_j} \right) < d\left( {{{{\mathbf{x}}}}_i,{{{\mathbf{y}}}}_i} \right)} \right}} \right|} \end{array} $$
(41)
其中, 、 $n_{1}^{\left(\right. i \left.\right)}$ 和 、 $n_{2}^{\left(\right. i \left.\right)}$ 分别表示在第一个和第二个数据集中,与 第 i 个细胞比其在对应数据集中的真实匹配更接近的细胞数量。d 为欧氏距离 。FOSCTTM 的取值范围为 0 到 1,值越低表示准确度越高。
特征一致性用于评估不同模型特征嵌入的一致性。由于原始嵌入空间在不同模型之间无法直接比较,我们将一致性定义为同一模型中特征间余弦相似度的跨模态守恒性。具体而言,我们首先随机抽取2000个特征,并使用来自两个待比较模型的特征嵌入计算它们之间的两两余弦相似度。然后,我们将特征一致性得分定义为两个模型余弦相似度之间的皮尔逊相关系数,并对四个随机子样本取平均值。特征一致性的取值范围为-1到1,数值越高表示一致性越高。
对于基线基准测试,除 Harmony 和 bindSC 外,每种方法均使用不同的随机种子运行八次。Harmony 和 bindSC 具有确定性实现,因此仅运行一次。对于引导图损坏基准测试,我们移除了指定比例的现有峰-基因相互作用,并添加了等量的不存在的相互作用,因此相互作用总数保持不变。值得注意的是,我们还使用损坏的引导图重复了特征转换。损坏过程使用不同的随机种子重复了八次。对于子采样基准测试,我们将 scRNA-seq 和 scATAC-seq 细胞成对进行子采样(以便仍然可以计算 FOSCTTM)。子采样过程也使用不同的随机种子重复了八次。
为了进行系统可扩展性测试(补充图 17a ),所有方法均在一台配备 40 个 CPU 核心(两颗 Intel Xeon Silver 4210 芯片)、250 GB 内存和 NVIDIA GeForce RTX 2080 Ti 图形处理器的 Linux 工作站上运行。训练 GLUE 时仅使用一张图形处理器卡。
三组学整合#
scRNA-seq 和 scATAC-seq 数据的处理方法如前所述(参见 “系统基准测试 ”部分)。由于单 C 位点的覆盖度较低,snmC-seq 数据被转换为基因体内的平均甲基化水平。mCH 和 mCG 水平分别进行定量,每个基因得到两个特征。基因甲基化水平通过每个细胞的全局甲基化水平进行标准化。使用 PCA 进行初始降维( 参见“实现细节 ”部分)。对于三组学指导图,mCH 和 mCG 水平通过负边与相应的基因连接。
标准化后的甲基化水平为正值,缺失值对应于单细胞中未覆盖的基因。因此,我们使用零膨胀对数正态分布(ZILN)作为数据解码器:
$p \left(\right. \mathbf{x}{k} \left|\right. \mathbf{u} , \mathbf{V} ; \theta{k} \left.\right) = \underset{i \in \mathcal{V}{k}}{\prod} Z I L N \left(\right. \mathbf{x}{k}{i} ; \mu{i} , \sigma_{i} , \delta_{i} \left.\right)$ $$ \begin{array}{*{20}{c}} {p\left( {{{{\mathbf{x}}}}k|{{{\mathbf{u}}}},{{{\mathbf{V}}}};\theta k} \right) = \mathop {\prod }\limits{i \in {{{\mathcal{V}}}}k} {{{\mathrm{ZILN}}}}\left( {{\mathbf{x}{k}}{i};{{{\mathbf{\mu }}}}_i,{{{\mathbf{\sigma }}}}_i,{{{\mathbf{\delta }}}}_i} \right)} \end{array} $$
(42)
$Z I L N \left(\right. \mathbf{x}{k}{i} ; \mu_{i} , \sigma_{i} , \delta_{i} \left.\right) = \left{\right. \begin{matrix}\frac{1 - \delta_{i}}{\mathbf{x}{k}{i} \sigma_{i} \sqrt{2 \pi}} exp \left(\right. - \frac{\left(\left(\right. log \mathbf{x}{k}{i} - \mu_{i} \left.\right)\right)^{2}}{2 \sigma_{i}^{2}} \left.\right) , & \mathbf{x}{k}{i} > 0 \ \delta_{i} , & \mathbf{x}{k}{i} = 0\end{matrix}$ $$ \begin{array}{{20}{c}} {{\mathrm{ZILN}}\left( {{\mathbf{x}{k}}{i};{{{\mathbf{\mu }}}}_i,{{{\mathbf{\sigma }}}}_i,{{{\mathbf{\delta }}}}_i} \right) = \left{ {\begin{array}{{20}{l}} {\frac{{1 - {{{\mathbf{\delta }}}}i}}{{{\mathbf{x}{k}}{i}{{{\mathbf{\sigma }}}}i\sqrt {2\pi } }}\exp \left( { - \frac{{\left( {\log {\mathbf{x}{k}}{i} - {{{\mathbf{\mu }}}}i} \right)^2}}{{2{{{\mathbf{\sigma }}}}i^2}}} \right),} \hfill & {{\mathbf{x}{k}}{i} > 0} \hfill \ {{{{\mathbf{\delta }}}}i,} \hfill & {{\mathbf{x}{k}}_{i} = 0} \hfill \end{array}} \right.} \end{array} $$
(43)
$\mu_{i} = \alpha \bigodot \mathbf{V}_{k}^{\top} \mathbf{u} + \beta$ $$ \begin{array}{*{20}{c}} {{{{\mathbf{\mu }}}}_i = \mathbf{\alpha} \odot {{{\mathbf{V}}}}_k^ \top \mathbf{u} + \mathbf{\beta} } \end{array} $$
(44)
其中 $\mu \in \mathbb{R}^{\left|\right. \mathcal{V}{k} \left|\right.} , \sigma \in \mathbb{R}{+}^{\left|\right. \mathcal{V}{k} \left|\right.} , \delta \in \left(\left(\right. 0 , 1 \left.\right)\right)^{\left|\right. \mathcal{V}{k} \left|\right.}$ 分别是零膨胀对数正态分布的对数尺度均值、对数尺度标准差和零膨胀参数, $\alpha \in \mathbb{R}{+}^{\left|\right. \mathcal{V}{k} \left|\right.} , \beta \in \mathbb{R}^{\left|\right. \mathcal{V}_{k} \left|\right.}$ 是缩放因子和偏差因子。
为了统一细胞类型标签,我们以 snmC-seq 数据集为参考,进行了基于最近邻的标签转移。在比对后的嵌入空间中,我们为每个 scRNA-seq 和 scATAC-seq 细胞识别了 snmC-seq 中的五个最近邻,并采用多数投票法确定转移的标签。为了验证比对的正确性,我们检测了细胞类型标记基因的显著重叠。首先,我们将所有组学层的特征转换为基因。然后,对于每个组学层,我们使用一对多 Wilcoxon 秩和检验来识别细胞类型标记,检验标准如下:scRNA-seq/scATAC-seq 的 FDR ≥ 0.05 且 log2 倍数变化≥0.00;snmC-seq 的 FDR ≥ 0.05 且 log2 倍数变化≥0.00。标记重叠的显著性通过三因素 Fisher 精确检验确定。
为了在整合后进行相关性和回归分析,我们使用精细尺度的 k 均值聚类算法( k =200)对来自三个组学层的所有细胞进行聚类。然后,对于每个组学层,通过对每个聚类中的细胞进行表达/可及性计数求和或对其 DNA 甲基化水平取平均值,将每个聚类中的细胞聚合为一个元细胞。这些元细胞被构建为配对样本,基于此可以进行特征相关性和回归分析。
为了使用在线 iNMF 整合相同的数据集,我们按照原始论文 [^16] 中描述的步骤,通过从数据矩阵中减去最大条目来反转 snmC-seq 数据。
基于 GLUE 的顺式调控推断#
为确保细胞类型的一致性,我们首先筛选出 10X Multiome 和 pcHi-C 数据中重叠的细胞类型。剩余的细胞类型包括 T 细胞、B 细胞和单核细胞。由于 eQTL 数据不具有细胞类型特异性,因此我们直接使用这些数据。对于 scRNA-seq,我们选择了 6000 个高变异基因。为了捕获远端 顺式 调控相互作用,我们使用 “系统基准测试” 部分所述的替代方案,构建了距离在 150 kb 以内的峰-基因对的基础指导图。
为了整合 pcHi-C 和 eQTL 的调控证据,我们将所有证据锚定在 ATAC 峰与 RNA 基因之间的相互作用上。如果满足以下条件,则认为峰-基因对得到 pcHi-C 的支持:(1)基因启动子位于诱饵片段 1 kb 范围内;(2)峰位于另一端片段 1 kb 范围内;(3)在 pcHi-C 中,诱饵片段与另一端片段之间存在显著接触。pcHi-C 支持的峰-基因相互作用的权重通过将启动子到诱饵片段的幂律权重和峰到另一端片段的幂律权重相乘(如上所述)来计算。如果一个峰-基因对得到多个 pcHi-C 接触的支持,则将这些权重相加,并限制为最大值 1。如果满足以下条件,则认为峰-基因对得到 eQTL 的支持:(1)峰与 eQTL 位点重叠;(2)该位点与基因的表达相关。 eQTL 支持的峰-基因相互作用被赋予 1 的权重。复合指导图是通过将 pcHi-C 和 eQTL 支持的相互作用添加到先前的基于距离的相互作用中构建的,允许存在多条边。
对于调控推断,仅考虑距离在 150 kb 以内的峰-基因对。GLUE 训练过程使用不同的随机种子重复四次。每次重复训练中,峰-基因调控得分计算为特征嵌入之间的余弦相似度。最终的调控推断结果通过对四次重复训练的调控得分取平均值得到。为了评估调控得分的显著性,我们将这些得分与通过随机打乱特征嵌入得到的零分布进行比较,并计算经验 P 值,即在零分布中获得更极端得分的概率。最后,我们使用 Benjamini-Hochberg 方法,基于 P 值计算调控推断的错误发现率 (FDR)。对于使用 LASSO 的 顺式 调控推断,我们使用超参数 α = 0.01,该参数针对 pcHi-C 和 eQTL 预测的受试者工作特征曲线下面积 (AUC) 进行了优化。
TF 靶基因调控推断#
我们使用 SCENIC 工作流程 [^76] 从推断的峰-基因调控相互作用中构建了 TF-基因调控网络。简而言之,SCENIC 工作流程首先基于 scRNA-seq 数据构建基因共表达网络,然后利用外部 顺式 调控证据过滤掉假阳性结果。SCENIC 接受以每个 TF 的基因排名形式提供的 顺式 调控证据,即在其调控区域中 TF 富集水平更高的基因排名更高。为了基于我们推断的峰-基因相互作用构建排名,我们首先将 ENCODE TF 染色质免疫沉淀 (ChIP) 峰 [^77] 与 ATAC 峰进行重叠,并统计每个 ATAC 峰中每个 TF 的 ChIP 峰数量。由于不同基因可能具有不同数量的连接的 ATAC 峰,并且 ATAC 峰的长度也各不相同(较长的峰可能偶然包含更多的 ChIP 峰),因此我们设计了一种基于抽样的方法来评估 TF 富集情况。具体而言,对于每个基因,我们随机抽取了 1000 组 ATAC 峰,这些峰在数量和长度分布上均与连接的 ATAC 峰相匹配。我们将这些随机 ATAC 峰中的 TF ChIP 峰数量作为零分布进行统计。对于每个基因中的每个 TF,通过比较观察到的 ChIP 峰数量与零分布,可以计算出一个经验 P 值。最后,我们根据每个 TF 的经验 P 值对基因进行排序,从而得到 SCENIC 使用的 顺式 调控排名。由于基于峰-基因的推断主要集中于远端调控区域,因此可能会遗漏近端启动子。因此,我们同时向 SCENIC 提供了基于峰和基于近端启动子的 顺式 调控排名。
人类多组学图谱的整合#
scRNA-seq 和 scATAC-seq 图谱的细胞类型组成极不平衡,这主要是由于器官样本量差异造成的(补充图 17b )。尽管在实际分析中细胞类型未知,但器官来源通常是可用的,可用于平衡整合过程。为了进行器官平衡的数据预处理,我们首先对每个组学层进行子采样,使其与器官组成相匹配。对于 scRNA-seq 数据,我们使用器官平衡的子样本选择了 4000 个高变异基因。然后,为了进行初始降维,我们对器官平衡的子样本分别拟合了 PCA(scRNA-seq)和 LSI(scATAC-seq),并将投影应用于完整数据。PCA/LSI 坐标被用作 GLUE 数据编码器中的第一个转换层(参见 “实现细节 ”部分),以及用于元细胞聚合(见下文)。引导图的构建方法如前所述(参见 “系统基准测试 ”部分)。
这两个图谱包含大量细胞,但每个细胞的覆盖度较低。为了同时缓解 dropout 并提高训练速度,我们在预训练阶段采用了元细胞聚合策略。具体来说,在预训练阶段,我们使用精细尺度的 k 均值聚类算法对每个组学层中的细胞进行聚类(scRNA-seq 的 k =100,000,scATAC-seq 的 k =40,000)。为了同时平衡器官组成,我们首先在之前器官平衡的子样本上拟合 k 均值聚类中心,然后将其应用于完整数据集。每个 k 均值聚类中的细胞通过对其表达/可及性计数求和并对其 PCA/LSI 坐标取平均值而聚合成一个元细胞。然后,我们使用添加噪声对这些聚合的元细胞进行 GLUE 预训练,这些噪声可以大致调整细胞嵌入的方向,但不会实际对齐它们( 参见“加权对抗比对 ”部分)。为了更好地利用大数据,隐藏层的维度从默认的 256 增加到 512。在第二阶段,使用完整的单细胞数据对 GLUE 进行微调,平衡权重的估计方法详见 “加权对抗比对” 部分。在比较不同方法的可扩展性时,未使用元细胞聚合(补充图 17a )。
为了与其他整合方法进行比较,我们还尝试了在线 iNMF 和 Seurat v.3。在线 iNMF 是唯一能够扩展到数百万个细胞的方法,因此我们将其应用于完整数据集。另一方面,Seurat v.3 在我们之前的基准测试中表现出第二高的准确率。由于 Seurat v.3 无法扩展到完整数据集,我们也将其应用于 GLUE 训练第一阶段使用的聚合数据(补充图 17a )。标签迁移采用与三组学情况相同的步骤,只是我们在 50 个最近邻中使用了多数投票法。
报告摘要#
有关研究设计的更多信息,请参阅本文链接的《 自然研究报告摘要》 。
数据可用性#
本研究中使用的所有数据集均已发表,并来自公共数据存储库。有关本研究中使用的单细胞组学数据集的详细信息,包括访问代码和 URL,请参见补充表 1。 用于调控推断和评估的 pcHi-C 数据来自原始出版物的补充文件( https://www.sciencedirect.com/science/article/pii/S0092867416313228),eQTL 数据来自 GTEx v8( https://www.gtexportal.org/home/datasets ),TF ChIP-seq 数据来自 ENCODE 数据门户( https://www.encodeproject.org/),TRRUST v2 数据库来自官方网站( https://www.grnpedia.org/trrust/downloadnetwork.php )。所有基准测试源数据均可在补充数据 1 中找到。
代码可用性#
GLUE 框架已在 Python 包“scglue”中实现,该包可在 https://github.com/gao-lab/GLUE 获取。为了保证结果的可复现性,所有基准测试和案例研究的脚本均使用 Snakemake (v.6.12.3) 编译,该软件包也可在上述仓库中找到。
参考#
致谢#
我们感谢北京大学的唐峰、谢晓松、张志强、陶磊、李晨、卢军以及北京放射医学研究所的丁勇在研究过程中提供的有益讨论和建议,并感谢本研究中使用的数据集的作者们提供的帮助。本研究由国家重点研发计划(项目编号:2016YFC0901603)、北京大学蛋白质与植物基因研究国家重点实验室、北京基因组学高精尖创新中心以及昌平实验室资助。GG 的研究部分由国家高层次青年人才支持计划资助。部分分析工作在北京大学生命科学中心计算平台完成,并得到了北京大学高性能计算平台的支持。图 1 的部分图像来自 Servier Medical Art( https://smart.servier.com/,CC BY 3.0)下载的数据集。
伦理声明#
利益冲突#
作者声明不存在利益冲突。
同行评审#
同行评审信息#
《自然生物技术》 感谢 Ricard Argelaguet、Yun Li、Romain Lopez 和其他匿名审稿人对这项工作的同行评审所做出的贡献。
附加信息#
出版商声明: 施普林格·自然出版社对已出版地图中的管辖权主张和机构隶属关系保持中立。
扩展数据#
扩展数据图 1 用于评估集成性能的各项指标。#
a ,不同整合方法的平均精度均值与 Seurat 比对得分的关系。平均精度均值越高,表示细胞类型分辨率越高;Seurat 比对得分越高,表示组学混合效果越好。b , 不同整合方法的细胞类型与组学层平均轮廓宽度的关系。细胞类型平均轮廓宽度越高,表示细胞类型分辨率越高;组学层平均轮廓宽度越高,表示组学混合效果越好。c , 不同整合方法的邻域保守性与图连通性的关系。邻域保守性越高,表示各原始层中流形结构的保守性越好;图连通性越高,表示组学混合效果越好。n=8 次重复实验,每次实验使用不同的模型随机种子。误差线表示平均值±标准差。
扩展数据图 2 先验知识和数据规模对集成性能的影响。#
a ,基于先验特征关系的整合方法在不同先验知识损坏率下的总体整合得分下降情况(n=8,重复 8 次,每次使用不同的损坏随机种子) 。b ,总体整合得分 。c ,基于先验特征关系的整合方法,采用不同的峰与基因连接方案作为先验调控知识,FOSCTTM 的总体整合得分(n=8,每次使用不同的模型随机种子)。“Combined±0”是标准方案,其中与基因体或启动子区域重叠的峰被连接。“Promoter±150k”表示如果峰位于基因启动子 150kb 范围内,则将其与基因连接,权重由模拟染色质接触概率 [^42] [^43] 的幂律函数决定。d , 不同整合方法在不同大小的子采样数据集上的总体整合得分(n=8,每次使用不同的子采样随机种子)。误差线表示平均值±标准差。
扩展数据图 3 GLUE 在不同超参数设置下的集成性能。#
整合性能通过以下指标量化: a ,总体整合得分; b ,FOSCTTM(n=4,使用不同的模型随机种子重复 4 次)。误差线表示均值±标准差。“维度”表示细胞嵌入维度。“预处理维度”是用于数据编码器第一变换层的降维维度(参见“方法”部分)。“隐藏层深度”是数据编码器和模态判别器中隐藏层的数量。“隐藏层维度”是数据编码器和模态判别器中隐藏层的维度。“Dropout”是数据编码器和模态判别器中隐藏层的 dropout 率。“Lambda 图”是图损失的权重( $\lambda_{\mathcal{G}}$ )。“Lambda 对齐”是对抗对齐的权重( λ D )。 “负采样率”是指负边缘采样中使用的经验样本数量(来自 p ns 的样本)。对于每个超参数,中心值是默认值。为了控制计算成本,每次只改变一个超参数,其他所有超参数均设置为默认值。GLUE 的性能在各种超参数设置下都表现稳健,但对抗对齐权重过低或神经网络中未使用隐藏层(相当于容量不足的线性模型)导致的对齐失败除外。
扩展数据图 4 GLUE 与不同数量的高变异基因的整合性能。#
整合性能通过以下指标量化: a) 总体整合得分; b) FOSCTTM(n=8 次重复实验,每次实验使用不同的模型随机种子)。误差线表示平均值±标准差。
扩展数据图 5 GLUE 特征嵌入的鲁棒性。#
特征嵌入的一致性(由特征间余弦相似度的守恒性定义,详见 “方法”部分 )在以下三种情况下进行评估: a )不同的超参数设置(n=4 次重复实验,每次使用不同的模型随机种子); b) 不同的先验知识损坏率(n=8 次重复实验,每次使用不同的损坏随机种子) ;c )不同的子采样单元格数量(n=8 次重复实验,每次使用不同的子采样随机种子)。误差线表示平均值±标准差。除 $\lambda_{\mathcal{G}}$ 外,特征嵌入在所有超参数下均表现出鲁棒性, λG 直接控制引导图的贡献。即使先验知识损坏率高达 40%,且子采样单元格数量至少为~4000,一致性仍然很高(> 0.8)。
扩展数据图 6 检测过度校正的集成一致性得分。#
针对不同数据集组合,使用不同数量的元细胞进行整合一致性评分。同组织组合代表正确校正,异组织组合代表过度校正。虚线水平线表示整合一致性评分 = 0.05。
补充信息#
补充信息(下载 PDF)#
补充图 1-23 和表 1。
报告摘要(下载 PDF)#
补充数据 1(下载 XLSX 文件)#
详细的基准测试数据。
补充数据 2(下载 XLSX 文件)#
GLUE 衍生 TF 靶基因网络中的调控相互作用。
权利和许可#
开放获取: 本文根据知识共享署名 4.0 国际许可协议(Creative Commons Attribution 4.0 International License)授权,允许在任何媒介或格式下使用、分享、改编、分发和复制,但必须注明原作者和来源,提供指向知识共享许可协议的链接,并说明是否进行了修改。本文中的图像或其他第三方材料均包含在本文的知识共享许可协议中,除非材料的署名另有说明。如果材料未包含在本文的知识共享许可协议中,且您的预期用途不符合法律法规规定或超出许可范围,则您需要直接从版权所有者处获得许可。如需查看此许可协议的副本,请访问 http://creativecommons.org/licenses/by/4.0/ 。
[^1]: Cusanovich, DA 等。通过组合细胞索引对染色质可 及性进行多重单细胞分析。Science 348, 910–914 (2015)。
Article CAS PubMed PubMed Central Google Scholar
[^2]: Chen, X., Miragaia, RJ, Natarajan, KN & Teichmann, SA. 一种快速而稳健的单细胞染色质可及性分析方法。Nat . Commun. 9, 5345 (2018)。
Article CAS PubMed PubMed Central Google Scholar
[^3]: Luo, C. 等。单细胞甲基化组鉴定哺乳动物皮层中的神经元亚型和调控元件。Science 357 , 600–604 (2017)。
Article CAS PubMed PubMed Central Google Scholar
[^4]: Mulqueen, RM 等。单细胞中 DNA 甲基化谱的高度可扩展生成。Nat . Biotechnol. 36, 428–431 (2018)。
Article CAS PubMed PubMed Central Google Scholar
[^5]: Picelli, S. 等。Smart-seq2 用于单细胞中灵敏的全长转录组分析。Nat . Methods 10, 1096–1098 (2013)。
Article CAS PubMed Google Scholar
[^6]: Zheng, GX 等人。单细胞大规模并行数字转录谱分析。Nat . Commun. 8, 14049 (2017)。
Article CAS PubMed PubMed Central Google Scholar
[^7]: Packer, J. & Trapnell, C. 单细胞多组学:基因调控新定量模型的引擎。Trends Genet. 34, 653–665 (2018)。
Article CAS PubMed PubMed Central Google Scholar
[^8]: Chen, S., Lake, BB & Zhang, K. 同一细胞中转录组和染色质可及性的高通量测序。Nat . Biotechnol. 37, 1452–1457 (2019)。
Article CAS PubMed PubMed Central Google Scholar
[^9]: Ma, S. 等。通过共享的单细胞 RNA 和染色质分析鉴定染色质潜能。Cell 183, 1103–1116 (2020)。
Article CAS PubMed PubMed Central Google Scholar
[^10]: Clark, SJ 等人。scNMT-seq 可实现单细胞染色质可及性 DNA 甲基化和转录的联合分析。Nat . Commun. 9, 781 (2018)。
Article PubMed PubMed Central Google Scholar
[^11]: Wang, Y. 等。单细胞多组学测序揭示了早期胚胎的功能调控图谱。 自然通讯 12, 1247 (2021)。
Article CAS PubMed PubMed Central Google Scholar
[^12]: Lake, BB 等。人类成年大脑转录和表观遗传状态的整合单细胞分析。Nat . Biotechnol. 36, 70–80 (2018)。
Article CAS PubMed Google Scholar
[^13]: Bravo Gonzalez-Blas, C. 等。通过单细胞转录组学和表观基因组学的空间整合来鉴定基因组增强子。Mol . Syst. Biol. 16, e9438 (2020)。
Article PubMed PubMed Central Google Scholar
[^14]: Argelaguet, R., Cuomo, ASE, Stegle, O. & Marioni, JC. 单细胞数据整合的计算原理和挑战。Nat . Biotechnol. 39, 1202–1215 (2021)。
[^15]: Stuart, T. 等人。单细胞数据的全面整合。Cell 177, 1888–1902 (2019)。
Article CAS PubMed PubMed Central Google Scholar
[^16]: Gao, C. 等人。利用在线学习进行迭代单细胞多组学整合。 自然生物技术 39, 1000–1007 (2021)。
Article CAS PubMed PubMed Central Google Scholar
[^17]: Welch, JD 等。单细胞多组学整合比较和对比脑细胞身份的特征。Cell 177, 1873–1887 (2019)。
Article CAS PubMed PubMed Central Google Scholar
[^18]: Korsunsky, I. 等人。利用 Harmony 快速、灵敏、准确地整合单细胞数据。Nat . Methods 16, 1289–1296 (2019)。
Article CAS PubMed PubMed Central Google Scholar
[^19]: Chen, H. 等。单细胞 ATAC-seq 数据分析的计算方法评估。Genome Biol. 20, 241 (2019)。
Article PubMed PubMed Central Google Scholar
[^20]: Duren, Z. 等。通过耦合非负矩阵分解对单细胞基因组学数据进行整合分析。 美国国家科学院院刊 115, 7723–7728 (2018)。
Article CAS PubMed PubMed Central Google Scholar
[^21]: Zeng, W. 等人。DC3 是一种从批量和单细胞基因组学数据中进行反卷积和耦合聚类的方法。Nat . Commun. 10, 4613 (2019)。
Article PubMed PubMed Central Google Scholar
[^22]: Demetci, P.、Santorella, R.、Sandstede, B.、Noble, WS 和 Singh, R. SCOT:单细胞多组学比对与最优传输。J . Comput. Biol. 29, 3–18 (2022)。
Article CAS PubMed Google Scholar
[^23]: 曹凯、白晓、洪宇、万莉。用于单细胞多组学整合的无监督拓扑比对。 生物信息学 36 ,i48–i56 (2020)。
Article CAS PubMed PubMed Central Google Scholar
[^24]: 曹凯、洪宇、万莉,《使用 pamona 进行异构单细胞多组学数据整合的流形比对》, 生物信息学 38,211-219 (2021)。
[^25]: Singh, R. 等。单细胞多组学数据的无监督流形比对。载于 第 11 届 ACM 国际生物信息学、计算生物学和健康信息学会议论文集 (Aluru, S.、Kalyanaraman, A. 和 Wang, MD 编辑)a40(美国计算机协会,2020 年)。
[^26]: Svensson, V., Vento-Tormo, R. & Teichmann, SA. 过去十年单细胞 RNA 测序呈指数级增长。Nat . Protoc. 13, 599–604 (2018)。
Article CAS PubMed Google Scholar
[^27]: Kozareva, V. 等。小鼠小脑皮层的转录组图谱全面定义了细胞类型。Nature 598, 214–219 (2021)。
Article CAS PubMed PubMed Central Google Scholar
[^28]: 曹建等。人类胎儿基因表达细胞图谱。 科学 370, eaba7721 (2020)。
Article CAS PubMed PubMed Central Google Scholar
[^29]: Domcke, S. 等人。胎儿染色质可及性的人类细胞 图谱 。Science 370, eaba7612 (2020)。
Article CAS PubMed PubMed Central Google Scholar
[^30]: Lopez, R., Regier, J., Cole, MB, Jordan, MI & Yosef, N. 用于单细胞转录组学的深度生成建模。Nat . Methods 15, 1053–1058 (2018)。
Article CAS PubMed PubMed Central Google Scholar
[^31]: 曹,ZJ,魏,L.,卢,S.,杨,DC 和高,G。通过 Cell BLAST 的无偏细胞嵌入搜索大规模 scRNA-seq 数据库。 纳特。交流。 11、3458 (2020)。
Article CAS PubMed PubMed Central Google Scholar
[^32]: Kipf, TN & Welling, M. 变分图自编码器。载于 神经信息处理系统贝叶斯深度学习研讨会 (Gal, Y. 等编)(Curran Associates, Inc.,2016 年)。
[^33]: Dou, J. 等人。单细胞多组学数据的无偏整合。预印本发表于 bioRxiv https://doi.org/10.1101/2020.12.11.422014 (2020 年)
[^34]: 来自健康供体的 PBMC,单细胞多组 ATAC 基因表达演示数据,由 Cell Ranger ARC 1.0.0 提供。10X Genomics https://support.10xgenomics.com/single-cell-multiome-atac-gex/datasets/1.0.0/pbmc_granulocyte_sorted_10k (2020)。
[^35]: Muto, Y. 等。单细胞转录和染色质可及性分析重新定义了成人肾脏的细胞异质性。Nat . Commun. 12, 2190 (2021)。
Article CAS PubMed PubMed Central Google Scholar
[^36]: Yao, Z. 等。小鼠初级运动皮层的转录组和表观基因组细胞图谱。Nature 598, 103–110 (2021)。
Article CAS PubMed PubMed Central Google Scholar
[^37]: Saunders, A. 等。成年小鼠脑细胞的分子多样性和特化。Cell 174, 1015–1030 (2018)。
Article CAS PubMed PubMed Central Google Scholar
[^38]: 来自成年小鼠脑的新鲜皮层(v1),Cell Ranger 1.1.0 的单细胞 ATAC 演示数据。10X Genomics https://support.10xgenomics.com/single-cell-atac/datasets/1.1.0/atac_v1_adult_brain_fresh_5k (2019)。
[^39]: Mo, A. 等。哺乳动物大脑中神经元多样性的表观基因组特征。Neuron 86 , 1369–1384 (2015)。
Article CAS PubMed PubMed Central Google Scholar
[^40]: 王明、赵勇、张斌. 多集交集的有效测试与可视化. 科学报告. 5, 16923 (2015).
Article CAS PubMed PubMed Central Google Scholar
[^41]: Gabel, HW 等。Rett 综合征中 DNA 甲基化依赖性长基因抑制的破坏。Nature 522, 89–93 (2015)。
Article CAS PubMed PubMed Central Google Scholar
[^42]: Dekker, J., Marti-Renom, MA & Mirny, LA 探索基因组的三维组织:解释染色质相互作用数据。Nat . Rev. Genet. 14, 390–403 (2013)。
Article CAS PubMed PubMed Central Google Scholar
[^43]: Pliner, HA 等人。Cicero 从单细胞染色质可及性数据预测 顺式 调控 DNA 相互作用。Mol . Cell 71, 858–871 (2018)。
Article CAS PubMed PubMed Central Google Scholar
[^44]: Javierre, BM 等。谱系特异性基因组结构将增强子和非编码疾病变异与靶基因启动子联系起来 。Cell 167, 1369–1384 (2016)。
Article CAS PubMed PubMed Central Google Scholar
[^45]: Aguet, F. 等。 遗传效应对人类组织中基因表达的影响。Nature 550, 204–213 (2017)。
[^46]: Han, H. 等。TRRUST v2:人类和小鼠转录调控相互作用的扩展参考数据库。 核酸研究 46, D380–D386 (2018)。
Article CAS PubMed Google Scholar
[^47]: Thomsen, ER 等。人类放射状胶质细胞多样性的固定单细胞转录组学表征。Nat . Methods 13, 87–93 (2016)。
Article CAS PubMed Google Scholar
[^48]: Pollen, AA 等。人类皮层发育过程中外放射状胶质细胞 的分子特性。Cell 163, 55–67 (2015)。
Article CAS PubMed PubMed Central Google Scholar
[^49]: Fischer, DS 等人。Sfaira 加速单细胞基因组学中的数据和模型重用。Genome Biol. 22, 248 (2021)。
Article PubMed PubMed Central Google Scholar
[^50]: Tran, HTN 等人。单细胞 RNA 测序数据批次效应校正方法的基准测试。Genome Biol. 21, 12 (2020)。
Article CAS PubMed PubMed Central Google Scholar
[^51]: Stark, SG 等。SCIM:具有非配对特征集的通用单细胞匹配。 生物信息学 36, i919–i927 (2020)。
Article CAS PubMed PubMed Central Google Scholar
[^52]: Yang, KD 等人。使用自编码器在单细胞成像和测序数据之间进行多域翻译。Nat . Commun. 12, 31 (2021)。
Article CAS PubMed PubMed Central Google Scholar
[^53]: Eng, C.-HL 等人。利用 RNA seqfish 对组织进行转录组规模的超分辨率成像。Nature 568, 235–239 (2019)。
Article CAS PubMed PubMed Central Google Scholar
[^54]: Rodriques, SG 等。Slide-seq:一种可扩展的技术 ,用于以高空间分辨率测量全基因组表达。Science 363, 1463–1467 (2019)。
Article CAS PubMed PubMed Central Google Scholar
[^55]: Ly, L.-H. & Vingron, M. 插补对单细胞 RNA-seq 数据基因网络重建的影响。Patterns 3 , 100414 (2021)。
[^56]: Bandura, DR 等。质谱流式细胞术:基于电感耦合等离子体飞行时间质谱的实时单细胞多靶点免疫分析技术。 分析化学 81, 6813–6822 (2009)。
Article CAS PubMed Google Scholar
[^57]: Bartosovic, M.、Kabbe, M. 和 Castelo-Branco, G. 单细胞 CUT&Tag 分析复杂组织中的组蛋白修饰和转录因子。Nat . Biotechnol. 39, 825–835 (2021)。
Article CAS PubMed PubMed Central Google Scholar
[^58]: Ashuach, T.、Reidenbach, DA、Gayoso, A. 和 Yosef, N. PeakVI:用于单细胞染色质可及性分析的深度生成模型。Cell Reports Methods 2, 100182 (2022)。
Article CAS PubMed PubMed Central Google Scholar
[^59]: Hamilton, W. 等人, 《神经信息处理系统进展》 (Guyon, I. 等人编)1024–1034(Curran Associates, Inc.,2017 年)。
[^60]: Veličković, P. 等人。图注意力网络。载于 第 6 届国际学习表征会议论文集 (Bengio, Y. 和 LeCun, Y. 编辑)(ICLR,2018)。
[^61]: Vashishth, S.、Sanyal, S.、Nitin, V. 和 Talukdar, P. 基于组合的多关系图卷积网络。载于 第八届国际学习表征会议论文集 (Rush, A. 编辑)(ICLR,2020)。
[^62]: Zhang, R., Zou, Y. & Ma, J. Hyper-SAGNN:一种基于自注意力机制的超图图神经网络。载于 第八届国际学习表征会议论文集 (Rush, A. 编辑)(ICLR,2020)。
[^63]: Zhang, R., Zhou, T. & Ma, J. 利用 Higashi 进行多尺度和整合的单细胞 Hi-C 分析。Nat . Biotechnol. 40, 254–261 (2021)。
[^64]: Stuart, T. & Satija, R. 整合单细胞分析。Nat . Rev. Genet. 20, 257–272 (2019)。
Article CAS PubMed Google Scholar
[^65]: Amodio, M. & Krishnaswamy, S. MAGAN:生物流形的对齐。载于 第 35 届国际机器学习会议论文集 (Dy, JG Dy & Krause, A. 编辑)215–223(PMLR,2018)。
[^66]: Tarashansky, AJ 等。绘制后生动物单细胞图谱揭示细胞类型演化。eLife 10 , e66747 (2021)。
Article CAS PubMed PubMed Central Google Scholar
[^67]: Jung, I. 等人。人类基因组中以启动子为中心的长程染色质相互作用汇编。Nat . Genet. 51, 1442–1449 (2019)。
Article CAS PubMed PubMed Central Google Scholar
[^68]: Ding, J. & Regev, A. 深度生成模型嵌入单细胞 RNA-seq 谱在超球体和双曲空间上。 自然通讯 12, 2554 (2021)。
Article CAS PubMed PubMed Central Google Scholar
[^69]: Mikolov, T.、Sutskever, I.、Chen, K.、Corrado, G. 和 Dean, J. ,《神经信息处理系统进展》 (Burges, CJC 等编)3111–3119(Curran Associates, Inc.,2013 年)。
[^70]: Kipf, TN & Welling, M. 使用图卷积网络的半监督分类。在 第五届国际学习表征会议论文集 (Bengio, Y. & LeCun, Y. 编辑)(ICLR,2017)。
[^71]: Dincer, AB, Janizek, JD & Lee, S.-I. 对抗性去混淆自编码器用于学习稳健的基因表达嵌入。 生物信息学 36, i573–i582 (2020)。
Article CAS PubMed PubMed Central Google Scholar
[^72]: Goodfellow, I. 等人, 《神经信息处理系统进展》 (Ghahramani, Z. 等人编辑)2672–2680(Curran Associates, Inc.,2014 年)。
[^73]: Luecken, MD 等。单细胞基因组学中图谱级数据整合的基准测试。Nat . Methods 19, 41–50 (2022)。
[^74]: Xu, C. 等。利用深度生成模型对单细胞转录组数据进行概率协调和注释。 分子系统生物学 17, e9620 (2021)。
Article PubMed PubMed Central Google Scholar
[^75]: Butler, A.、Hoffman, P.、Smibert, P.、Papalexi, E. 和 Satija, R. 整合不同条件、技术和物种的单细胞转录组数据。Nat . Biotechnol. 36, 411–420 (2018)。
Article CAS PubMed PubMed Central Google Scholar
[^76]: Aibar, S. 等。SCENIC:单细胞调控网络推断和聚类。Nat . Methods 14, 1083–1086 (2017)。
Article CAS PubMed PubMed Central Google Scholar
[^77]: Davis, CA 等。DNA 元件百科全书(ENCODE):数据门户更新。 核酸研究 46, D794–D801 (2018)。