01_图谱构建与整合/run_scvi_fbs.py
python · 13553 bytes
from scvi.external import MRVI
import scvi
import scanpy as sc
import anndata as ad
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.ticker as ticker
import os
from matplotlib.colors import to_hex
from scipy.cluster.hierarchy import linkage, optimal_leaf_ordering
from scipy.spatial.distance import squareform

adata_path='/nfs/team298/ls34/disease_atlas/mrvi/adata_scvi4_removedjunk_v2.h5ad'
adata=sc.read_h5ad(adata_path)

sc.pp.normalize_total(adata, target_sum=1e4)
sc.pp.log1p(adata)

HVG_BATCH_KEY = "sample_id"
hvg_number = 6000
HVG_BATCH_MINIMUM=80
MAX_EPOCHS=30

hypoxia = ["VEGFA",
"TF",
"SLC2A1-AS1",
"FOXN1",
"VDAC1",
"ASMT",
"PLS3",
"GPI",
"DARS",
"SNAPC1",
"SEC61G",
"GTF2IRD2B",
"SAP30",
"ZMYND8",
"RSBN1",
"BNIP3L",
"GTF2IRD2",
"STC2",
"NARF",
"HK2",
"INHA",
"PCF11",
"CBWD3",
"RAD51-AS1",
"S100P",
"HIF1A",
]

additional_genes_to_exclude = [                             'JUND', 'HSPA1A', 'DNAJB1', 'EEF1A1', 'HSP90AA1', 'FTH1', 'FTL', 'HSPB1', 'XIST', 'VGLL3', "MEG3",
                              "JUNB", "HSPA1B",  "FOSB", "HSP90AA1", "FOS", "DNAJB4", 'HSPA6', 'JUN', "NEAT1", "SOD2", "SOD3", "G0S2", "MYC"]


original_hvg = str(hvg_number) + "select" + str(HVG_BATCH_MINIMUM)
additional_genes_to_exclude = additional_genes_to_exclude + hypoxia

mask_to_exclude = (
    #adata_hvg.var.cc_fetal |
    adata.var.hb |
    adata.var.mt |
   # adata.var.mt2 |
    #adata.var.col |
    adata.var.ribo |
    adata.var.index.isin(additional_genes_to_exclude)
)
mask_to_include = ~mask_to_exclude
adata  = adata[:, mask_to_include]
sc.pp.highly_variable_genes(adata,
                            n_top_genes=hvg_number,
                            subset=False,
                            batch_key=HVG_BATCH_KEY,
                            check_values=False,
                           )
var_genes_all = adata.var.highly_variable
var_genes_batch = adata.var.highly_variable_nbatches > HVG_BATCH_MINIMUM
var_select = adata.var.highly_variable_nbatches >= HVG_BATCH_MINIMUM
var_genes = var_select.index[var_select]
hvg_number = len(var_genes)
print(f"selected {hvg_number} HVGs!")

adata2=sc.read_h5ad(adata_path)
label_dict = adata.var['highly_variable_nbatches'].to_dict()
adata2.var['highly_variable_nbatches'] = adata2.var.index.map(label_dict).fillna(np.nan)
label_dict = adata.var['highly_variable'].to_dict()
adata2.var['highly_variable'] = adata2.var.index.map(label_dict).fillna(False)
adata2.write(adata_path)
print(f"Added HVGs")

adata=adata2.copy()
adata2=0

best_HVG_BATCH_MINIMUM = None
closest_hvg_number = None
closest_difference = float('inf')
for HVG_BATCH_MINIMUM in [10,20,30,40,50, 60,70, 90,100,110, 120,135, 150,160,180, 200,220,250,300]:
    var_genes_batch = adata.var.highly_variable_nbatches > HVG_BATCH_MINIMUM
    var_select = adata.var.highly_variable_nbatches >= HVG_BATCH_MINIMUM
    var_genes = var_select.index[var_select]
    hvg_number = len(var_genes)

    difference = abs(hvg_number - 6000)

    if difference < closest_difference:
        closest_difference = difference
        closest_hvg_number = hvg_number
        best_HVG_BATCH_MINIMUM = HVG_BATCH_MINIMUM
HVG_BATCH_MINIMUM=best_HVG_BATCH_MINIMUM
hvg_number=closest_hvg_number
CAT_COVS=[]
CAT_COVS_TEMP = [x.replace("_", "").lower() for x in CAT_COVS]
collapsed_string = "_".join(CAT_COVS_TEMP)
if len(CAT_COVS) == 0:
    model_details= "HVGNUMBER" + str(hvg_number) + "__MINBATCH" + str(HVG_BATCH_MINIMUM) + "__MAXEPOCHS" + str(MAX_EPOCHS) + "__BATCHKEY" + HVG_BATCH_KEY
else:
    model_details= "HVGNUMBER" + str(hvg_number) + "__MINBATCH" + str(HVG_BATCH_MINIMUM) + "__MAXEPOCHS" + str(MAX_EPOCHS) + "__COVS" + collapsed_string
print(f"selected {hvg_number} HVGs!")
var_select = adata.var.highly_variable_nbatches >= HVG_BATCH_MINIMUM
adata = adata[:, var_select]
print(f"{hvg_number} selected -> {adata.shape}")

run_scanvi=False
run_mrvi=False
SCANVI_LABELS_KEY="lvl0_annotation"
SCANVI_UNLABELLED="New/unlabelled/excluded"
adata=adata.copy()
if run_scanvi==True:
    print("RUN SCANVI")
    def run_scvi(adata_hvg,  hvg_number , max_epochs, batch_size_vae, N_LATENT=10, N_LAYERS=1):
        DISPERSION = 'gene'
        try:
            details = "hvg" + str(hvg_number) +   '_'.join(CATEGORICAL_COV) + '_'.join(CONTINUOUS_COV) +  "_maxepochs" + str(max_epochs) + "_nlatent" + str(N_LATENT)+"nlayers" + str(N_LAYERS) + "_BATCHKEY_" + HVG_BATCH_KEY.replace("_", "").lower()
        except:
            details="missing"
        adata_save_name = 'umap_' + details +"__1"
        print(adata_save_name)
        scvi.model.SCANVI.setup_anndata(adata_hvg,
                                 batch_key=HVG_BATCH_KEY,
                                  labels_key=SCANVI_LABELS_KEY,
                                        unlabeled_category=SCANVI_UNLABELLED
                                       )
        model = scvi.model.SCANVI(adata_hvg,
                        dispersion=DISPERSION,
                        n_latent = N_LATENT,
                        n_layers = N_LAYERS,
                       )
        model.train(accelerator ='gpu',
                    max_epochs=max_epochs,
                    early_stopping=True,
                   early_stopping_patience=5,
                   batch_size=batch_size_vae)
        print("model trained")
        latent = model.get_latent_representation()

        try:
            count=1
            plt.subplots(figsize=(10, 10))
            for key in model.history.keys():
                plt.subplot(4,3,count)
                plt.plot(model.history[key])
                plt.title(key)
                count+=1
            plt.show()
        except:
            print("Error with count")
            try:
                print(count)
            except:
                print("can't print count")
        return adata_hvg, model
elif run_scanvi==False:
    if run_mrvi==False:
        print("RUN scvi")
        sample_key = "sample_id"
        def run_scvi(adata_hvg,  hvg_number , max_epochs,  batch_size_vae, N_LATENT=10, N_LAYERS=1):
            DISPERSION = 'gene'
            try:
                details = "hvg" + str(hvg_number) +   '_'.join(CATEGORICAL_COV) + '_'.join(CONTINUOUS_COV) +  "_maxepochs" + str(max_epochs) + "_nlatent" + str(N_LATENT)+"nlayers" + str(N_LAYERS) + "_BATCHKEY_" + HVG_BATCH_KEY.replace("_", "").lower()
            except:
                details="missingdetails"
            adata_save_name = 'umap_' + details +"__1"
            print(adata_save_name)
            scvi.model.SCVI.setup_anndata(adata_hvg,
                                            batch_key=HVG_BATCH_KEY,
                                           )
            model = scvi.model.SCVI(adata_hvg,
                           )
            model.train(max_epochs=max_epochs,
                        early_stopping=True,
                        accelerator='gpu',
                       early_stopping_patience=5,
                       batch_size=batch_size_vae)
            print("model trained")
            return adata_hvg, model
    elif run_mrvi==True:
        print("RUN MRVI")
        sample_key = "sample_id"
        adata=adata[adata.obs["Site_status"]!="Postrx"]
        adata.obs["Site_status"] = adata.obs["Site_status"].cat.remove_unused_categories()
        def run_scvi(adata_hvg,  hvg_number , max_epochs,  batch_size_vae, N_LATENT=10, N_LAYERS=1):
            DISPERSION = 'gene'
            try:
                details = "hvg" + str(hvg_number) +   '_'.join(CATEGORICAL_COV) + '_'.join(CONTINUOUS_COV) +  "_maxepochs" + str(max_epochs) + "_nlatent" + str(N_LATENT)+"nlayers" + str(N_LAYERS) + "_BATCHKEY_" + HVG_BATCH_KEY.replace("_", "").lower()
            except:
                details="missingdetails"
            adata_save_name = 'umap_' + details +"__1"
            print(adata_save_name)
            MRVI.setup_anndata(adata_hvg,
                                           sample_key=sample_key,
                                            batch_key="dataset_id"
                                           )
            model = MRVI(adata_hvg,
                           )
            model.train(max_epochs=max_epochs,
                        early_stopping=True,
                       early_stopping_patience=5,
                        accelerator="gpu",
                       batch_size=batch_size_vae)
            print("model trained")
            return adata_hvg, model
adata, model_test = run_scvi(adata,
                     hvg_number=hvg_number,
                              max_epochs=MAX_EPOCHS,
                          batch_size_vae=512,
                                           N_LATENT=30,
                                          N_LAYERS=2 )
print("trained. now load adata")
adata=sc.read_h5ad(adata_path)
if not run_mrvi==True:
    print("mrvi false")
    latent = model_test.get_latent_representation()
    adata.obsm["X_scvi"] = latent
    adata.layers["counts"]=adata.X.copy()
    sc.pp.normalize_total(adata, target_sum=1e4)
    sc.pp.log1p(adata)
    neighbor=30
    neighbor_id = "neighbor_30"
    print("start neighbours")
    sc.pp.neighbors(adata, use_rep = 'X_scvi', metric = "euclidean", n_neighbors=neighbor,key_added=neighbor_id)
    print("neighbours done")
    mindist=0.2
    print("start umap")
    sc.tl.umap(adata, min_dist=mindist, neighbors_key =neighbor_id )

    print("finished umap")
    leidenres_list = [0.2]
    neighbor_id = 'neighbor_30'
    for leidenres in leidenres_list:
        print("###", leidenres)
        leiden_id = "leiden_res" + str(leidenres) # gayoso 1.2
        sc.tl.leiden(adata, resolution=leidenres, key_added=leiden_id, neighbors_key=neighbor_id)
    print("prep save")
    adata.write(adata_path+".integrated", compression="gzip")

    from datetime import datetime
    now = datetime.now()
    timestamp = now.strftime("%Y-%m-%d %H:%M:%S")
    print(f"Saved! Time: {timestamp}")

else:
    adata=adata[adata.obs["Site_status"]!="Postrx"]
    adata.obs["Site_status"] = adata.obs["Site_status"].cat.remove_unused_categories()

    latent = model_test.get_latent_representation()
    adata.obsm["X_mrvi_u"] = latent
    latent_z = model_test.get_latent_representation(give_z=True)
    adata.obsm["X_mrvi_z"] = latent_z
    neighbor=30
    neighbor_id = "neighbor_30_U"
    sc.pp.neighbors(adata, use_rep = 'X_mrvi_z', metric = "euclidean", n_neighbors=neighbor,key_added="neighbor_30_Z")
    sc.pp.neighbors(adata, use_rep = 'X_mrvi_u', metric = "euclidean", n_neighbors=neighbor,key_added=neighbor_id)
    print("neighbours done")
    sc.pp.neighbors(adata, use_rep = 'X_mrvi_z', metric = "euclidean", n_neighbors=neighbor,key_added="neighbor_30_Z")
    mindist=0.2
    sc.tl.umap(adata, min_dist=mindist, neighbors_key =neighbor_id )
    leidenres_list = [0.5]
    for leidenres in leidenres_list:
        print("###", leidenres)
        leiden_id = "leiden_res" + str(leidenres) # gayoso 1.2
        sc.tl.leiden(adata, resolution=leidenres, key_added=leiden_id, neighbors_key=neighbor_id)
    print("prep save")

    dists = model_test.get_local_sample_distances(
    keep_cell=False, groupby="lvl3_annotation", batch_size=32
    )
    print("dists below")
    print(dists)
    try:
        d1 = dists.loc[{"lvl3_annotation_name": "Th"}].initial_clustering
    except:
        print("fail with: dists.loc[{lvl3_annotation_name: Th}].initial_clustering")
    try:
        print(model_test.sample_info.columns)
    except:
        print("cant print model_test.sample_info.columns")
    try:
        print(model_test.sample_info["Site_status"].value_counts())
    except:
        print("cant print model_test.sample_info[status].value_counts")
    try:
        sample_cov_keys = ["Site_status"]
        model_test.sample_info["Site_status"] = model_test.sample_info["Site_status"].cat.reorder_categories(
            ["Nonlesional", "Lesional"]
        )
        de_res = model_test.differential_expression(
            sample_cov_keys=sample_cov_keys,
            store_lfc=True,
        )
        print("de_Res done")
    except:
        print("faill sample_imnfo")
    try:
        print(de_res)
    except:
        print("cant print deres")
    try:
        adata.obs["DE_eff_size"] = de_res.effect_size.sel(covariate="Status_Lesional").values
        print("DE_EFF_SIZE added")
    except:
        print("fail Covid_DE_eff_size")
    try:
        print("da_res below")
        print(model_test.differential_abundance)
    except:
        print("could not print model_test.differential_abundance")
    try:
        sample_cov_keys = ["Site_status"]
        da_res = model_test.differential_abundance(sample_cov_keys=sample_cov_keys)
        covid_log_probs = da_res.Status_log_probs.loc[{"Site_status": "Lesional"}]
        healthy_log_probs = da_res.Status_log_probs.loc[{"Site_status": "Nonlesional"}]
        covid_healthy_log_prob_ratio = covid_log_probs - healthy_log_probs
        adata.obs["DA_lfc"] = covid_healthy_log_prob_ratio.values
    except:
        print(f"fail. da_res is {da_rest}")

    adata.write(f'/nfs/team298/ls34/disease_atlas/mrvi/adata_mrvi_all_scvi4.h5ad')
    from datetime import datetime
    now = datetime.now()
    timestamp = now.strftime("%Y-%m-%d %H:%M:%S")
    print(f"Saved! Time: {timestamp} -> /nfs/team298/ls34/disease_atlas/mrvi/adata_mrvi_all.h5ad")
    model_test.save(f'/nfs/team298/ls34/disease_atlas/mrvi/scvi4_all_MRVIversion_{hvg_number}_new',
                   save_anndata=True)
08_小鼠与胎鼠fig8/extendedfig8c_monocle_plot.r
r · 5428 bytes
# Purpose: Monocle Trajetory analysis using F2 population as root node]

##### 1. Load Libraries #####
# Load libraries
library(monocle3)
library(ggplot2)
library(patchwork)


##### 2. Custom Functions #####

# Custom function to create a cell_data_set (CDS) object

## mtx: a count matrix or numeric matrix of gene expression values having genes as rows, and cells as columns.
## cellmeta: a dataframe having cells/barcodes metadata (equivalent to adata.obs)
## genemeta: a dataframe having gene/features metadata (equivalent to adata.vars)

## Notes:

#   - If the input matrix is in AnnData format (cells as rows, genes as columns),
#     set transpose_matrix = TRUE (default).
#   - If the input matrix is already in Monocle format (genes as rows, cells as columns),
#     set transpose_matrix = FALSE.


create_cds <- function(mtx, cellmeta, genemeta, transpose_matrix = TRUE) {
  # Check if the file exists
  if (!file.exists(mtx)) {
    stop("Error: input matrix file path does not exist.")
  }

  # Load the expression matrix
  expression_mtx <- tryCatch(
    readMM(mtx),
    error = function(e) {
      stop("Error: Failed to load the matrix. file not in the correct Matrix Market format.\n", e)
    }
  )

  # Optionally transpose the matrix
  if (transpose_matrix) {
    expression_mtx <- t(expression_mtx)
  } else {
    cat("Skipping transpose: assuming matrix in genes x cells format.\n")
  }

  # Set the row names and column names of the expression matrix
  rownames(expression_mtx) <- rownames(genemeta)  # Gene names as row names
  colnames(expression_mtx) <- rownames(cellmeta)  # Cell IDs as column names

  # Create the CDS object

  cat("Creating CellDataSet object.\n")
  cds <- tryCatch(
    new_cell_data_set(
      expression_data = expression_mtx,
      cell_metadata = cellmeta,
      gene_metadata = genemeta
    ),
    error = function(e) {
      stop("Error: Failed to create the CellDataSet object.check all input files are in correct format.\n", e)
    }
  )

  cat("CellDataSet object successfully created!\n")
  return(cds)
}


##### 3. Main Workflow #####

setwd('~/kc28/monocle3/')


# Step 1: Load Data

# Load cell and gene metadata
cellmeta <- read.csv('/nfs/users/nfs_k/kc28/kc28/monocle3/cell_metadata_HVGS_counts.csv', row.names = 1)
genemeta <- read.csv("/nfs/users/nfs_k/kc28/kc28/monocle3/gene_metadata_HVGS_counts.csv", row.names = 1)


# Step 2: Create cell_data_set (CDS) object


mtx = "expression_matrix_HVGS_counts.mtx"

cds_HGVS_counts = create_cds(mtx, cellmeta, genemeta, transpose_matrix = TRUE)

# Step 3: Preprocess Data

cds_HGVS_counts <- preprocess_cds( cds_HGVS_counts, method = "PCA", num_dim = 50)


# Step 4: Perform Alignemnt - Remove batch effects

cds_HGVS_counts <- align_cds(cds_HGVS_counts, num_dim = 100, alignment_group = "dataset_id", alignment_k = 20, verbose = TRUE)


# Step 5: Dimensionality Reduction using UMAP

cds_HGVS_counts <- reduce_dimension(cds_HGVS_counts, reduction_method='UMAP', verbose = TRUE)


# Step 6: Clustering of cells

cds_HGVS_counts <- cluster_cells(cds_HGVS_counts, reduction_method='UMAP', resolution=1e-4, verbose = TRUE)

# Step 7: Learning the trajectory graph

cds_HGVS_counts <- learn_graph(cds_HGVS_counts, use_partition = TRUE, close_loop = FALSE,
  learn_graph_control = list(
    geodesic_distance_ratio = 0.5,  # Lower for large datasets ; 0.2 - 10, 0.5 - 10 , 0.5 - 8 , 0.2 - 0.8
    minimal_branch_len = 10, # Higher to reduce short branches
    nn.cores=10 # 2/3 of available cores
  ),
  verbose = TRUE)

#saveRDS(cds_HGVS_counts , 'final_cds_HGVS_counts_aligned_graph_learned_nov19.rds')

# Step 8: Order the cells in pseudotime

# F2: Universal as root node - Manually selected the nodes belonging to F2 populations according to the 'test13' annotations. order_cells() launches a graphical user interface for selecting the root nodes.

cds_HGVS_counts = order_cells(cds_HGVS_counts, reduction_method = 'UMAP')


### 4. Plots  ####

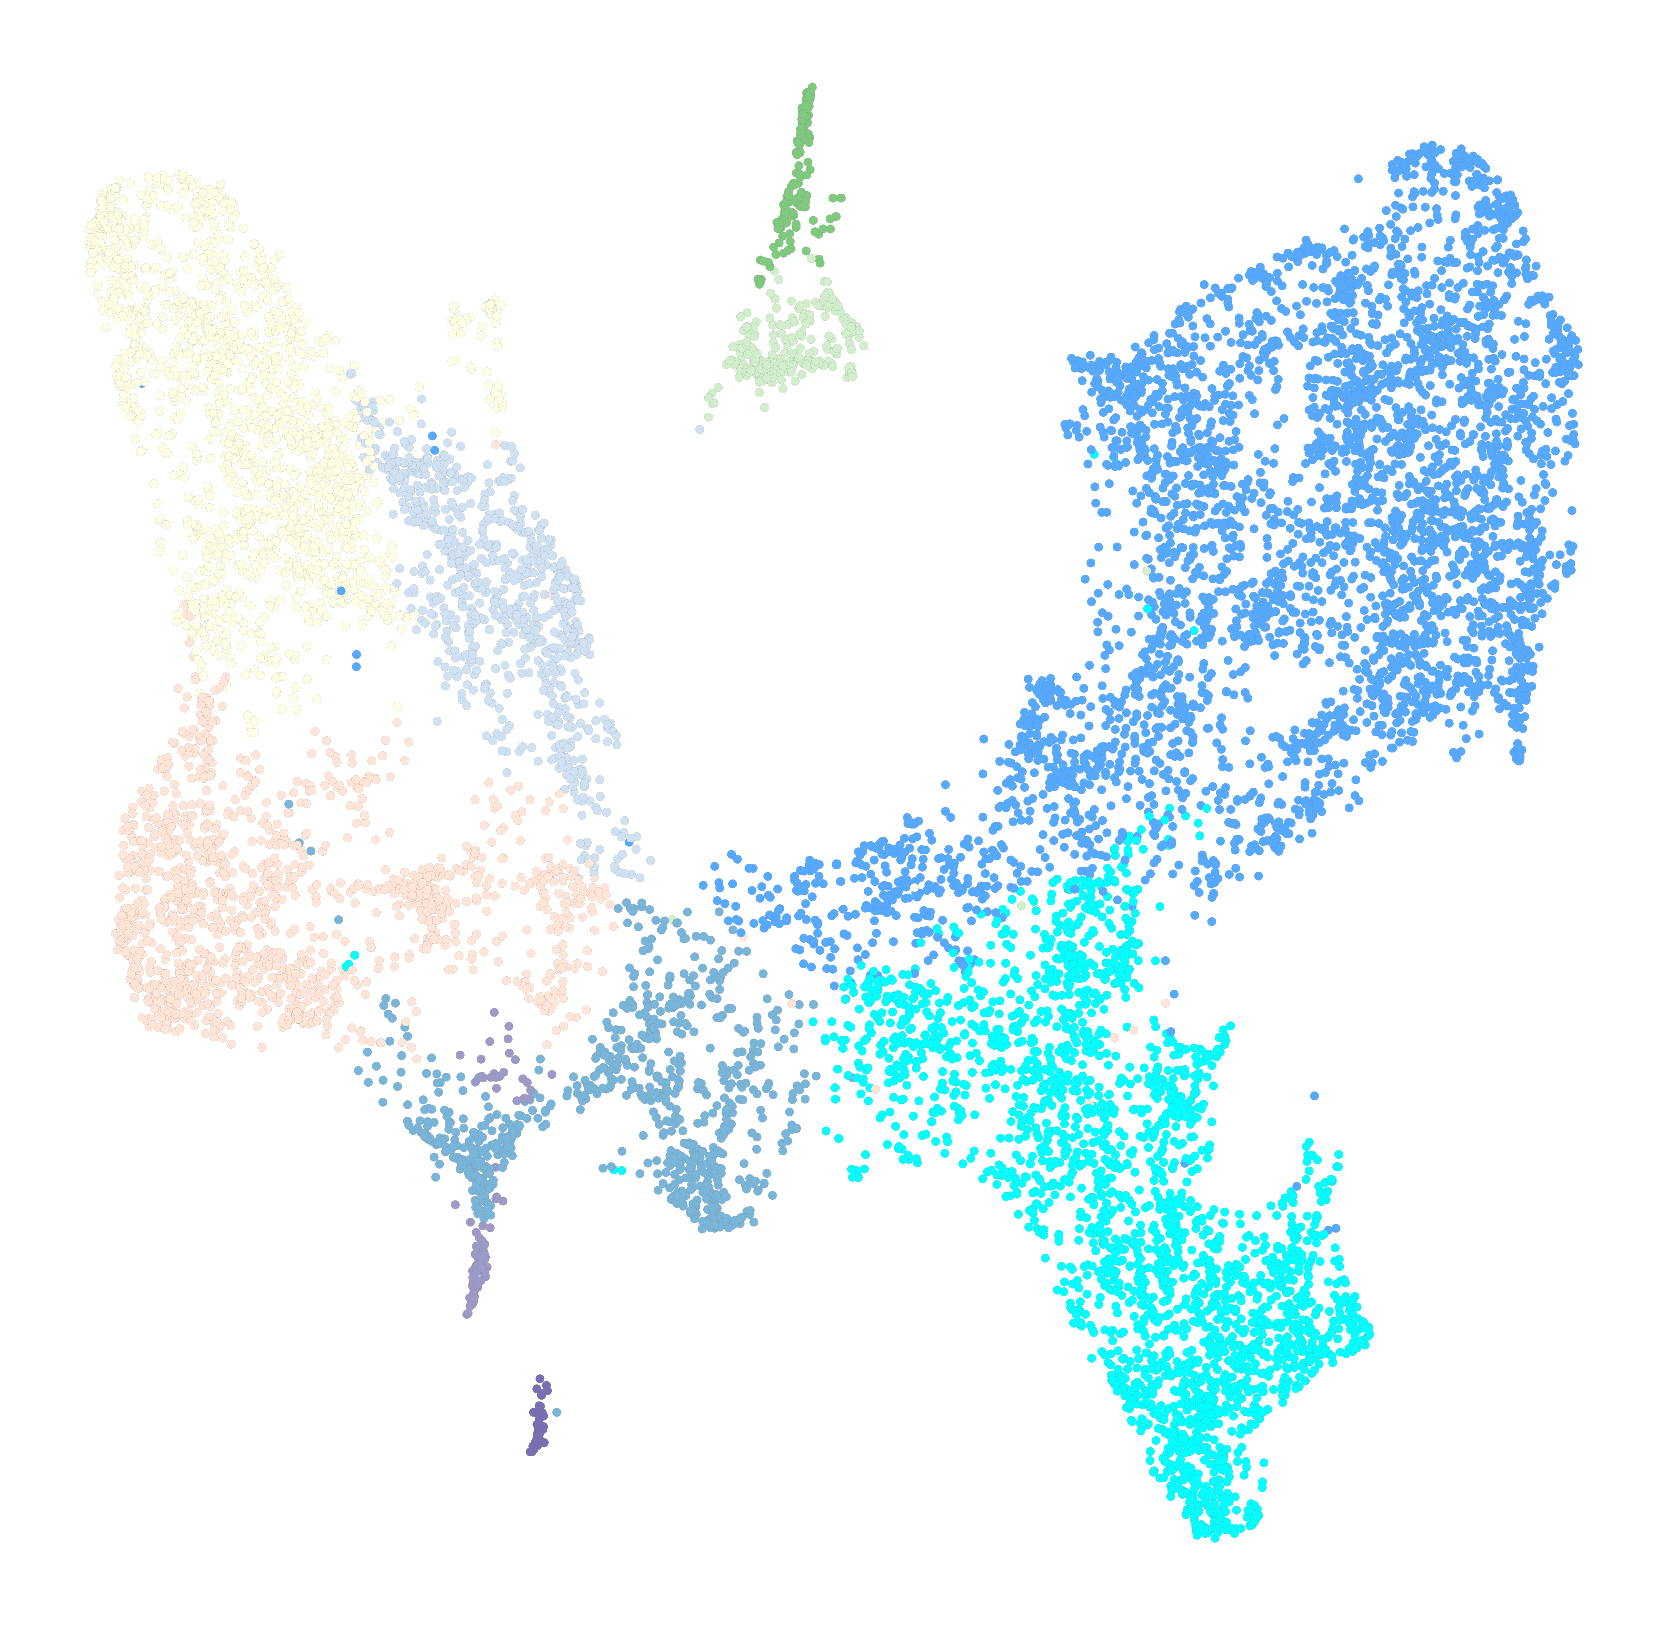
custom_colors <- c(
  'F1: Epithelium-associated' = rgb(1, 1, 0.898),
  'F1: Regenerative' = rgb(0.996, 0.809, 0.396),
  'F2: Universal' = rgb(0.814, 0.884, 0.95),
  'F2/3: Bridge' = rgb(0.473, 0.712, 0.851),
  'F3: FRC-like' = rgb(0.997, 0.896, 0.849),
  'F6: Myofibroblast inflammatory' = rgb(0, 1, 1),
  'F6: Myofibroblast' = rgb(0.333, 0.667, 1)
)


p1 = plot_cells(cds_HGVS_counts, color_cells_by="test13", label_cell_groups=FALSE,  label_groups_by_cluster=TRUE,
                label_leaves=FALSE, label_branch_points=FALSE, group_label_size = 2, cell_size = 0.80, trajectory_graph_color = "gray50",  label_principal_points = FALSE ) +
  scale_color_manual(values = custom_colors) +
  theme_void() + theme(legend.position = "none")

p2 = plot_cells(cds_HGVS_counts, color_cells_by="pseudotime",
                label_leaves=FALSE,
                label_branch_points=FALSE, trajectory_graph_color = "gray50",
                label_cell_groups=FALSE, cell_size = 0.80) + scale_color_gradientn(colors = c("blue", "grey", "red")) +
  labs(color = "pseudotime") +  theme_void()

plot1 =  p1 + p2
plot1

png('F2_dataset_cds_F2_as_root_node_new.png', height = 800 , width = 1600)
print(plot1)
dev.off()


saveRDS(cds_HGVS_counts, 'F2_dataset_cds_ordered_object.rds')


#### 5. Record Session Information #######

cat("Recording session information...\n")
session_info <- sessionInfo()
writeLines(capture.output(session_info), "session_info.txt")