参数要点
| 参数 | 默认 | 说明 |
|---|---|---|
node_colors |
自动 | 节点名 → #RRGGBB |
link_alpha |
0.45 | 连线透明度;太实会盖住节点 |
show_labels |
true | 首末级标签朝内、中间级盖在条上 |
max_expand |
20000 | 权重展开上限,超了自动缩放 |
plot57 · 代码 4 · 图 1 · 笔记 1 · 代码库专题
1. 原稿用 networkD3 出交互式 HTML,但工具要静态图(进论文),所以改走
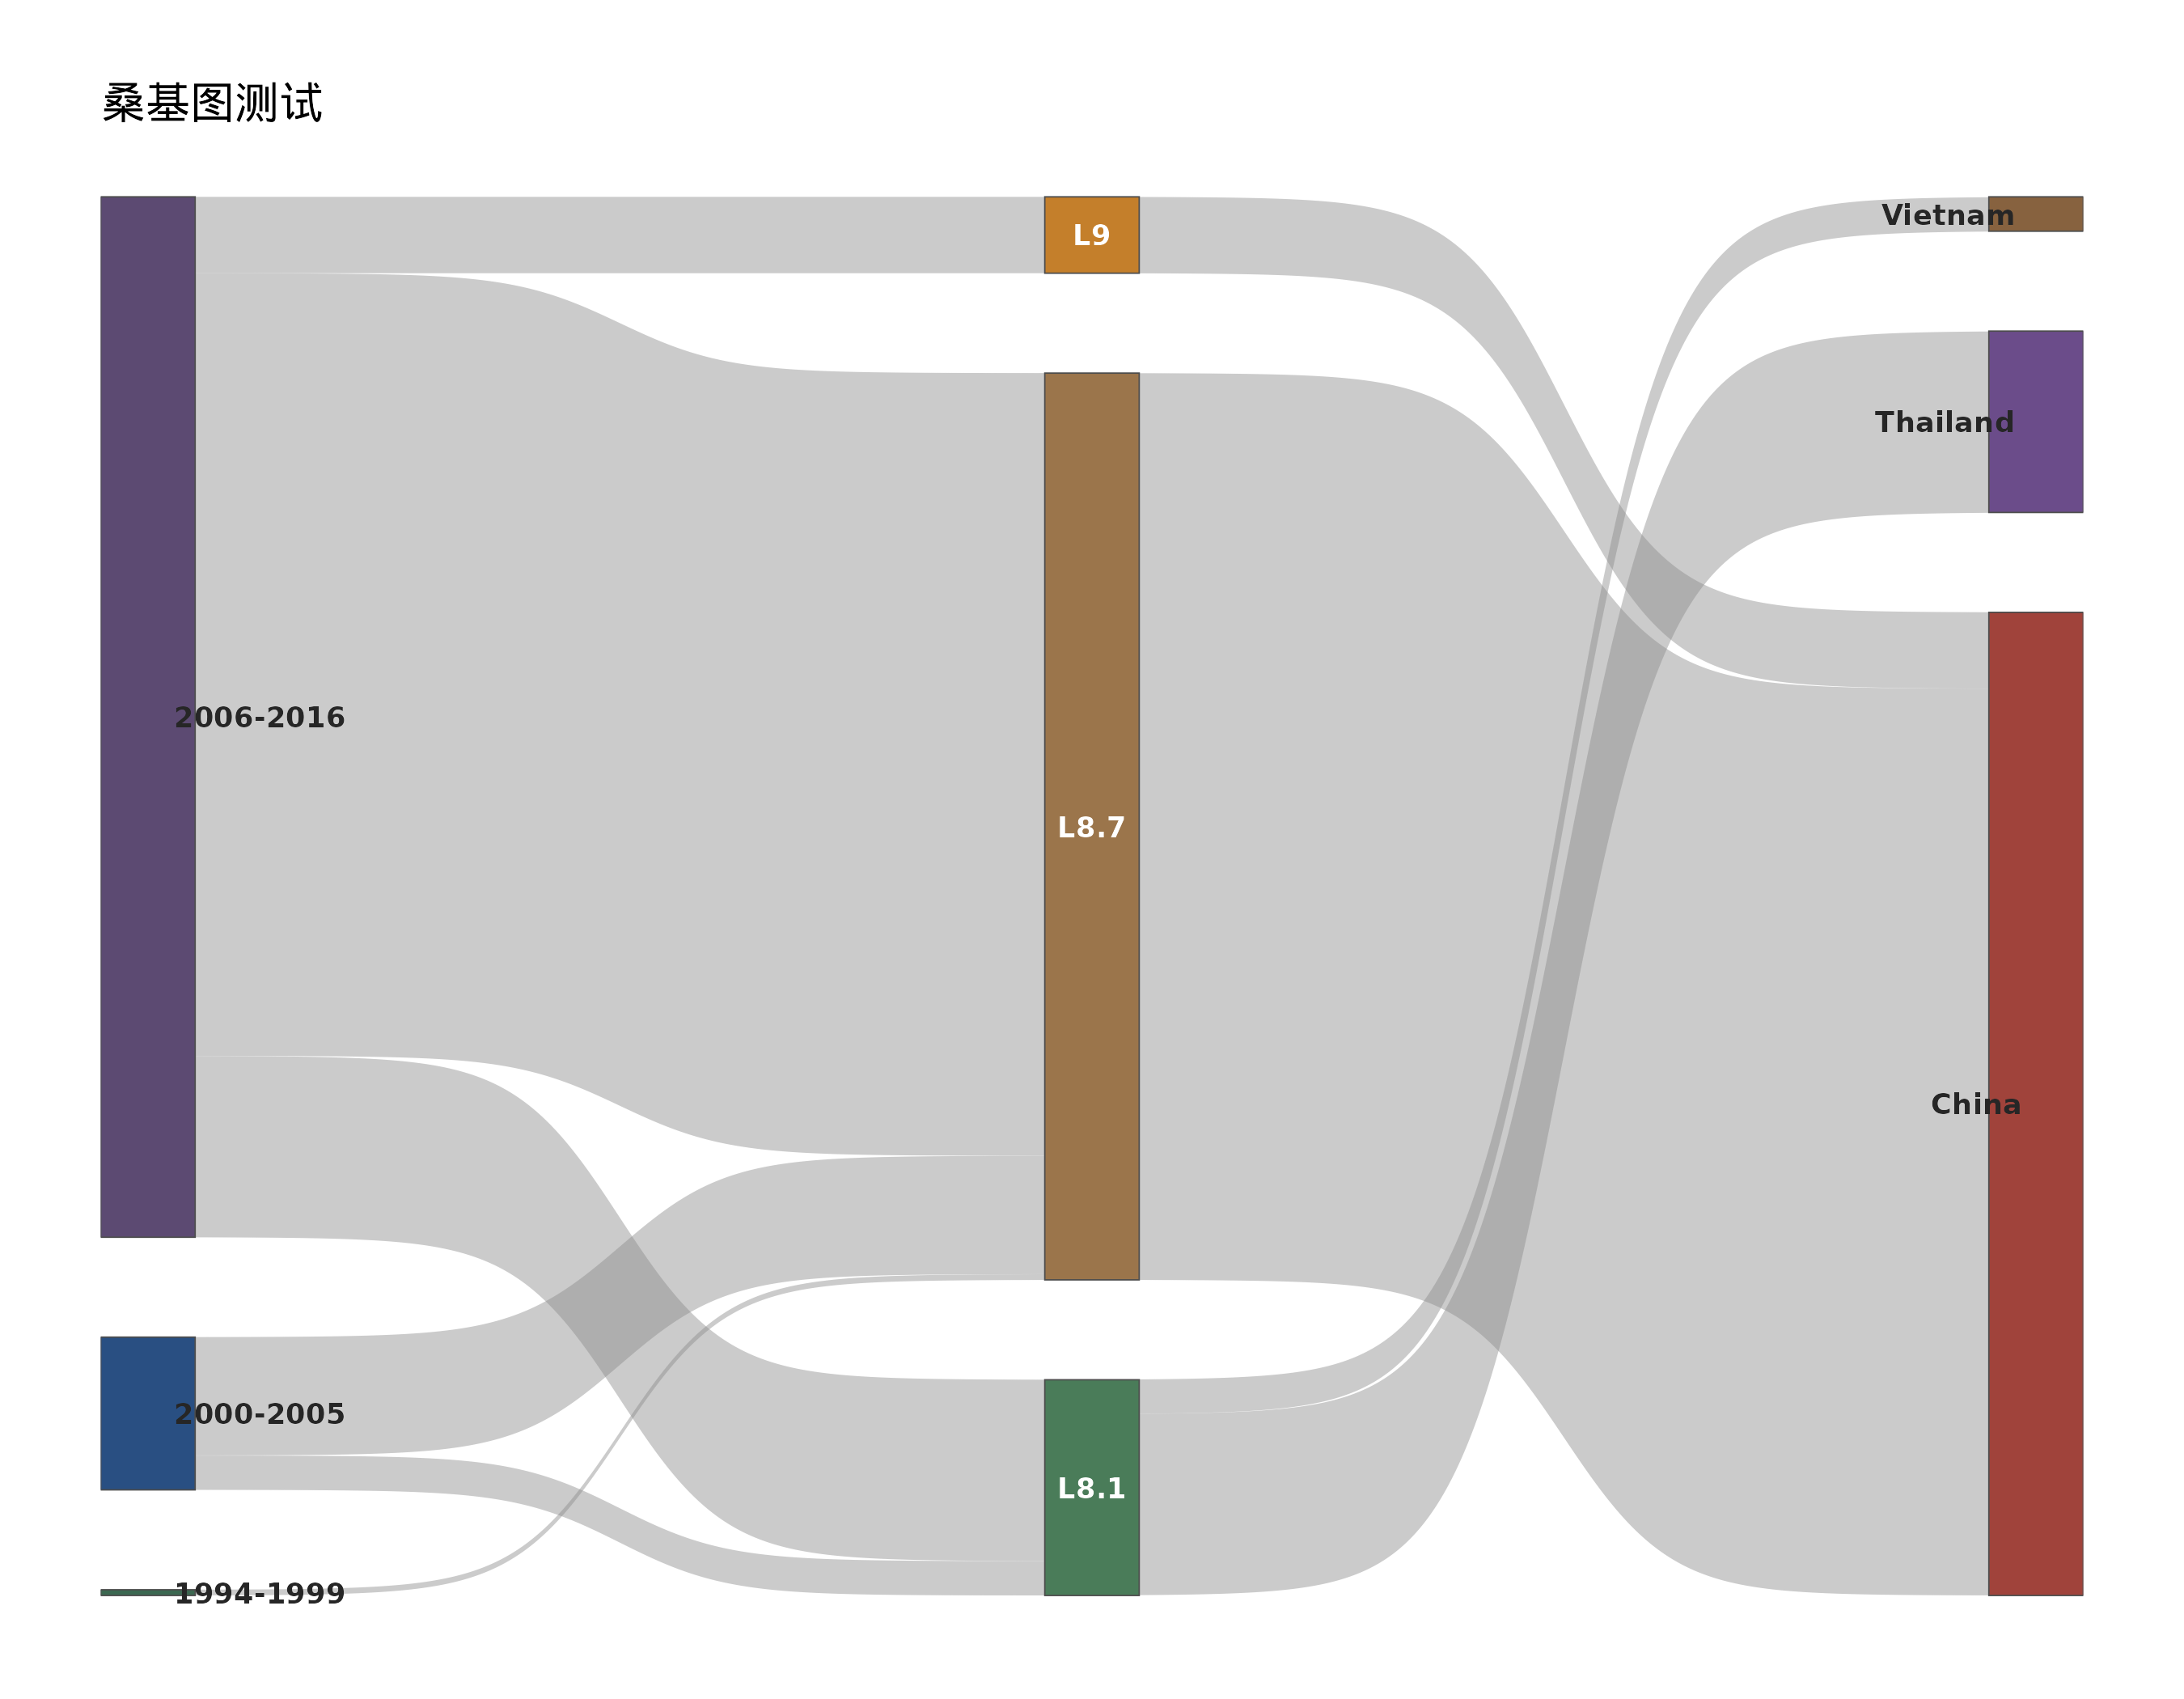
示例 sankey plot示例_sankey_plot.png
图源:示例_sankey_plot.png
从专题 README 抽取;原文顺序保留,未跑过的部分照实标注。
展示「从哪来、到哪去、各占多少」:样本随时间/分组的流向、细胞亚群的来源转变、
多组学数据的构成分解。
| 参数 | 默认 | 说明 |
|---|---|---|
node_colors |
自动 | 节点名 → #RRGGBB |
link_alpha |
0.45 | 连线透明度;太实会盖住节点 |
show_labels |
true | 首末级标签朝内、中间级盖在条上 |
max_expand |
20000 | 权重展开上限,超了自动缩放 |
边表(一行一条流向):
source,target,value
1994-1999,L8.7,3
2000-2005,L8.7,62宽表(一行一条完整路径):
stage1,stage2,stage3,value
2006-2016,L8.7,China,410render_plot method_id="plot57"
arguments: {"csv_path": "your.csv",
"columns": {"source": "stage1", "target": "stage2", "value": "value"}}networkD3 出交互式 HTML,但工具要静态图(进论文),所以改走ggsankey。两者数据格式不通用,需要把边表展开成"一行一元素"。make_long() 的输出只有 x/node/next_x/next_node 四列,没有 value。aes() 里不能映射 value,object 'value' not found。geom_sankey_label() 不能用 —— 它内部按 value 分组算位置,同样因为没有stat = "sankeynode" 也不是公开 stat 名。ggplot_build() 里读节点图层的 ymin/ymax,再自己 geom_text。hjust 方向容易写反:hjust=0 是文字左边贴 x(向右延伸),hjust=1 是右边贴 x(向左延伸)。首级要朝内写 -0.15,末级写 1.15。MsTt模板/241103_sankey/(networkD3 交互版原稿 + 两份数据)。
4 个源码文件,按目录顺序;本机绝对路径已替换为 ~。 代码可复制,但需要按自己的数据改路径与参数。
# 生成第一个桑基图

# 加载必要的包
library(networkD3)
library(tidyverse)
library(htmlwidgets)

# 设置工作目录
setwd("~/Downloads/MSTT 笔记/241103_sankey")

# 读取数据
data0 = read.csv("sankey1_data.csv", stringsAsFactors = FALSE)

print("数据已加载")
print(paste("数据行数:", nrow(data0)))
print(head(data0))

data <- data0 %>%
  group_by(Timeline, `Lineages.Distribution`, `Geographic.Location`, `P.M.A.s`) %>%
  summarise(Count = n(), .groups = 'drop')

print("数据已分组汇总")
print(paste("汇总后数据行数:", nrow(data)))
print(head(data))

# 定义每一层节点的顺序
timeline_order <- unique(data$Timeline)
lineages_order <- rev(unique(data$`Lineages.Distribution`))
geographic_order <- c("Russia", "Philippines", "Laos", "Cambodia", "India",
                      "Switzerland", "Thailand", "Vietnam", "China", "USA",
                      "Mexico", "Canada", "South Korea", "Japan")
geographic_order <- geographic_order[geographic_order %in% unique(data$`Geographic.Location`)]
pmas_order <- sort(unique(data$P.M.A.s), na.last = TRUE)

print("节点顺序已定义")

# 创建节点数据并按自定义顺序排序
nodes <- data.frame(name = c(timeline_order,
                             lineages_order,
                             geographic_order,
                             pmas_order))

print("节点数据已创建")
print(paste("节点数量:", nrow(nodes)))
print(head(nodes))

# 创建链接数据
links <- data %>%
  select(Timeline, Lineages.Distribution, Count) %>%
  rename(source = Timeline, target = Lineages.Distribution, value = Count) %>%
  bind_rows(
    data %>% select(Lineages.Distribution, Geographic.Location, Count) %>%
      rename(source = Lineages.Distribution, target = Geographic.Location, value = Count),
    data %>% select(Geographic.Location, P.M.A.s, Count) %>%
      rename(source = Geographic.Location, target = P.M.A.s, value = Count)
  ) %>%
  group_by(source, target) %>%
  summarise(value = sum(value), .groups = 'drop') %>%
  ungroup()

print("链接数据已创建")
print(paste("链接数量:", nrow(links)))
print(head(links))

# 将source和target转换为节点索引
links$IDsource <- match(links$source, nodes$name) - 1  # networkD3的索引从0开始
links$IDtarget <- match(links$target, nodes$name) - 1

print("索引已转换")

# 自定义颜色列表
customColors <- c("#1f77b4", "#ff7f0e", "#2ca02c", "#d62728", "#9467bd",
                 "#8c564b", "#e377c2", "#7f7f7f", "#bcbd22", "#17becf",
                 "#aec7e8", "#ffbb78", "#98df8a", "#ff9896", "#c5b0d5",
                 "#c49c94", "#f7b6d2", "#c7c7c7", "#dbdb8d", "#9edae5")

# 创建颜色比例字符串
colourScale <- sprintf('d3.scaleOrdinal().range(["%s"])',
                       paste(customColors, collapse = '", "'))

print("开始创建桑基图")

p <- sankeyNetwork(Links = links,
              Nodes = nodes,
              Source = "IDsource",
              Target = "IDtarget",
              Value = "value",
              NodeID = "name",
              units = "T",
              fontSize = 13,
              nodeWidth = 30,
              height = 600,
              width = 1000,
              nodePadding = 14,
              iterations = 0,
              colourScale = colourScale)

print("桑基图已创建,正在保存")

# 保存HTML文件
saveNetwork(p, "sankey1_basic.html")

print("基础桑基图已保存为sankey1_basic.html")

# 添加渐变色效果
p1 <- htmlwidgets::onRender(p, '
  function(el, x) {
    var svg = d3.select(el).select("svg");

    // 创建一个合法的ID, 防止名称中有空格或者-等特殊字符
    function createValidID(name) {
      if (!name) {
        return "unknown"; // 如果名称是null或undefined,返回一个默认值
      }
      // 将非字母数字字符替换为下划线,包括空格和-
      return name.replace(/[^a-zA-Z0-9-]/g, "_");
    }

    // 收集要删除的节点名称(NA)
    var nodesToRemove = [];
    svg.selectAll(".node").each(function(d) {
      if (!d.name || d.name === "NA") {
        nodesToRemove.push(d.name);
      }
    });

    // 删除标签为NA的节点及其直接相关的链接
    nodesToRemove.forEach(function(nodeName) {
      // 找到并删除与该节点相关的所有直接链接
      svg.selectAll(".link").filter(function(link) {
        return link.target.name === nodeName;
      }).remove();

      // 删除节点
      svg.selectAll(".node").filter(function(node) {
        return node.name === nodeName;
      }).remove();
    });

    // 创建渐变色
    svg.selectAll(".link").each(function(d) {
      // 使用 source.name 和 target.name 作为渐变ID的一部分
      var gradientID = "gradient-" + createValidID(d.source.name) + "-" + createValidID(d.target.name);

      // 创建渐变
      var gradient = svg.append("defs")
        .append("linearGradient")
        .attr("id", gradientID)
        .attr("gradientUnits", "userSpaceOnUse")
        .attr("x1", d.source.x + d.source.dx / 2)
        .attr("y1", d.source.y + d.source.dy / 2)
        .attr("x2", d.target.x + d.target.dx / 2)
        .attr("y2", d.target.y + d.target.dy / 2);

      // 起始颜色(源节点颜色)
      var sourceColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.source.name; }).select("rect").style("fill");
      var targetColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.target.name; }).select("rect").style("fill");

      gradient.append("stop")
        .attr("offset", "0%")
        .attr("stop-color", sourceColor);

      // 终止颜色(目标节点颜色)
      gradient.append("stop")
        .attr("offset", "100%")
        .attr("stop-color", targetColor);

      // 设置链接的颜色为渐变色
      d3.select(this).style("stroke", "url(#" + gradientID + ")");
    });

    // 修改节点矩形框的颜色
    svg.selectAll(".node rect")
      .style("stroke", "black") // 设置矩形框的边框颜色
      .style("stroke-width", "1.5px"); // 设置矩形框的边框粗细
  }
')

# 保存HTML文件
saveNetwork(p1, "sankey1_gradient.html")

print("渐变效果桑基图已保存为sankey1_gradient.html")
# 运行桑基图代码

# 设置工作目录
setwd("~/Downloads/MSTT 笔记/241103_sankey")

# 加载必要的包
if (!requireNamespace("networkD3", quietly = TRUE)) install.packages("networkD3")
if (!requireNamespace("tidyverse", quietly = TRUE)) install.packages("tidyverse")
if (!requireNamespace("readxl", quietly = TRUE)) install.packages("readxl")
if (!requireNamespace("htmlwidgets", quietly = TRUE)) install.packages("htmlwidgets")
if (!requireNamespace("webshot", quietly = TRUE)) install.packages("webshot")

library(networkD3)
library(tidyverse)
library(readxl)
library(htmlwidgets)
library(webshot)

# ======= 复现一: Nature Communications 文章 =======

# 读取数据
data0 = read.csv("data1.csv", stringsAsFactors = FALSE)

data <- data0 %>%
  group_by(Timeline, `Lineages Distribution`, `Geographic Location`, `P.M.A.s`) %>%
  summarise(Count = n(), .groups = 'drop')

# 定义每一层节点的顺序
timeline_order <- unique(data$Timeline)
lineages_order <- rev(unique(data$`Lineages Distribution`))
geographic_order <- c("Russia", "Philippines", "Laos", "Cambodia", "India",
                      "Switzerland", "Thailand", "Vietnam", "China", "USA",
                      "Mexico", "Canada", "South Korea", "Japan")
pmas_order <- sort(unique(data$P.M.A.s), na.last = TRUE)

# 创建节点数据并按自定义顺序排序
nodes <- data.frame(name = c(timeline_order,
                             lineages_order,
                             geographic_order,
                             pmas_order))

# 创建链接数据
links <- data %>%
  select(Timeline, `Lineages Distribution`, Count) %>%
  rename(source = Timeline, target = `Lineages Distribution`, value = Count) %>%
  bind_rows(
    data %>% select(`Lineages Distribution`, `Geographic Location`, Count) %>%
      rename(source = `Lineages Distribution`, target = `Geographic Location`, value = Count),
    data %>% select(`Geographic Location`, `P.M.A.s`, Count) %>%
      rename(source = `Geographic Location`, target = `P.M.A.s`, value = Count)
  ) %>%
  group_by(source, target) %>%
  summarise(value = sum(value), .groups = 'drop') %>%
  ungroup()

# 将source和target转换为节点索引
links$IDsource <- match(links$source, nodes$name) - 1  # networkD3的索引从0开始
links$IDtarget <- match(links$target, nodes$name) - 1

# 自定义颜色列表
customColors <- c("#1f77b4", "#ff7f0e", "#2ca02c", "#d62728", "#9467bd",
                 "#8c564b", "#e377c2", "#7f7f7f", "#bcbd22", "#17becf",
                 "#aec7e8", "#ffbb78", "#98df8a", "#ff9896", "#c5b0d5",
                 "#c49c94", "#f7b6d2", "#c7c7c7", "#dbdb8d", "#9edae5")

# 创建颜色比例字符串
colourScale <- sprintf('d3.scaleOrdinal().range(["%s"])',
                       paste(customColors, collapse = '", "'))

p <- sankeyNetwork(Links = links,
              Nodes = nodes,
              Source = "IDsource",
              Target = "IDtarget",
              Value = "value",
              NodeID = "name",
              units = "T",
              fontSize = 13,
              nodeWidth = 30,
              height = 600,
              width = 1000,
              nodePadding = 14,
              iterations = 0,
              colourScale = colourScale)

# 渲染桑基图
p1 <- htmlwidgets::onRender(p, '
  function(el, x) {
    var svg = d3.select(el).select("svg");

    // 创建一个合法的ID, 防止名称中有空格或者-等特殊字符
    function createValidID(name) {
      if (!name) {
        return "unknown"; // 如果名称是null或undefined,返回一个默认值
      }
      // 将非字母数字字符替换为下划线,包括空格和-
      return name.replace(/[^a-zA-Z0-9-]/g, "_");
    }


    // 收集要删除的节点名称(NA)
    var nodesToRemove = [];
    svg.selectAll(".node").each(function(d) {
      if (!d.name || d.name === "NA") {
        nodesToRemove.push(d.name);
      }
    });

    // 删除标签为NA的节点及其直接相关的链接
    nodesToRemove.forEach(function(nodeName) {
      // 找到并删除与该节点相关的所有直接链接
      svg.selectAll(".link").filter(function(link) {
        return link.target.name === nodeName;
      }).remove();

      // 删除节点
      svg.selectAll(".node").filter(function(node) {
        return node.name === nodeName;
      }).remove();
    });


    // 创建渐变色
    svg.selectAll(".link").each(function(d) {

      // 使用 source.name 和 target.name 作为渐变ID的一部分
      var gradientID = "gradient-" + createValidID(d.source.name) + "-" + createValidID(d.target.name);

      // 创建渐变
      var gradient = svg.append("defs")
        .append("linearGradient")
        .attr("id", gradientID)
        .attr("gradientUnits", "userSpaceOnUse")
        .attr("x1", d.source.x + d.source.dx / 2)
        .attr("y1", d.source.y + d.source.dy / 2)
        .attr("x2", d.target.x + d.target.dx / 2)
        .attr("y2", d.target.y + d.target.dy / 2);

      // 起始颜色(源节点颜色)
      var sourceColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.source.name; }).select("rect").style("fill");
      var targetColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.target.name; }).select("rect").style("fill");

      gradient.append("stop")
        .attr("offset", "0%")
        .attr("stop-color", sourceColor);

      // 终止颜色(目标节点颜色)
      gradient.append("stop")
        .attr("offset", "100%")
        .attr("stop-color", targetColor);

      // 设置链接的颜色为渐变色
      d3.select(this).style("stroke", "url(#" + gradientID + ")");
    });

    // 修改节点矩形框的颜色
    svg.selectAll(".node rect")
      .style("stroke", "black") // 设置矩形框的边框颜色
      .style("stroke-width", "1.5px"); // 设置矩形框的边框粗细
  }
')

# 保存HTML文件
saveNetwork(p1, "sankey1_result.html")
# 保存PNG图片
webshot("sankey1_result.html", "sankey1_result.png", delay = 3)

# ======= 复现二: Nature Metabolism 文章 =======

# 读取数据
data = read.csv("data2.csv", stringsAsFactors = FALSE)

# 定义每一层节点的顺序
cluster_order <- unique(data$cluster)
mRNA1_order <- unique(data$mRNA1)
mRNA2_order <- unique(data$mRNA2)

# 创建节点数据并按自定义顺序排序
nodes <- data.frame(name = c(cluster_order, mRNA1_order, mRNA2_order))

# 创建链接数据
links <- data %>%
  select(cluster, mRNA1, Freq) %>%
  rename(source = cluster, target = mRNA1, value = Freq) %>%
  bind_rows(
    data %>% select(mRNA1, mRNA2, Freq) %>%
      rename(source = mRNA1, target = mRNA2, value = Freq)
  ) %>%
  group_by(source, target) %>%
  summarise(value = sum(value), .groups = 'drop') %>%
  ungroup()

# 将source和target转换为节点索引
links$IDsource <- match(links$source, nodes$name) - 1  # networkD3的索引从0开始
links$IDtarget <- match(links$target, nodes$name) - 1

# 自定义颜色列表
customColors <- c("#1f77b4", "#ff7f0e", "#2ca02c", "#d62728", "#9467bd",
                 "#8c564b", "#e377c2", "#7f7f7f", "#bcbd22", "#17becf",
                 "#aec7e8", "#ffbb78", "#98df8a", "#ff9896", "#c5b0d5",
                 "#c49c94", "#f7b6d2", "#c7c7c7", "#dbdb8d", "#9edae5")

# 创建颜色比例字符串
colourScale <- sprintf('d3.scaleOrdinal().range(["%s"])',
                       paste(customColors, collapse = '", "'))

p <- sankeyNetwork(Links = links,
                   Nodes = nodes,
                   Source = "IDsource",
                   Target = "IDtarget",
                   Value = "value",
                   NodeID = "name",
                   units = "T",
                   fontSize = 20,
                   nodeWidth = 15,
                   height = 600,
                   width = 800,
                   iterations = 0,
                   nodePadding = 10,
                   colourScale = colourScale)

# 渲染桑基图
p2 <- htmlwidgets::onRender(p, '
  function(el, x) {
    var svg = d3.select(el).select("svg");

    // 创建一个合法的ID, 防止名称中有空格或者-等特殊字符
    function createValidID(name) {
      if (!name) {
        return "unknown"; // 如果名称是null或undefined,返回一个默认值
      }
      // 将非字母数字字符替换为下划线,包括空格和-
      return name.replace(/[^a-zA-Z0-9-]/g, "_");
    }


    // 收集要删除的节点名称(NA)
    var nodesToRemove = [];
    svg.selectAll(".node").each(function(d) {
      if (!d.name || d.name === "NA") {
        nodesToRemove.push(d.name);
      }
    });

    // 删除标签为NA的节点及其直接相关的链接
    nodesToRemove.forEach(function(nodeName) {
      // 找到并删除与该节点相关的所有直接链接
      svg.selectAll(".link").filter(function(link) {
        return link.target.name === nodeName;
      }).remove();

      // 删除节点
      svg.selectAll(".node").filter(function(node) {
        return node.name === nodeName;
      }).remove();
    });


    // 创建渐变色
    svg.selectAll(".link").each(function(d) {

      // 使用 source.name 和 target.name 作为渐变ID的一部分
      var gradientID = "gradient-" + createValidID(d.source.name) + "-" + createValidID(d.target.name);

      // 创建渐变
      var gradient = svg.append("defs")
        .append("linearGradient")
        .attr("id", gradientID)
        .attr("gradientUnits", "userSpaceOnUse")
        .attr("x1", d.source.x + d.source.dx / 2)
        .attr("y1", d.source.y + d.source.dy / 2)
        .attr("x2", d.target.x + d.target.dx / 2)
        .attr("y2", d.target.y + d.target.dy / 2);

      // 起始颜色(源节点颜色)
      var sourceColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.source.name; }).select("rect").style("fill");
      var targetColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.target.name; }).select("rect").style("fill");

      gradient.append("stop")
        .attr("offset", "0%")
        .attr("stop-color", sourceColor);

      // 终止颜色(目标节点颜色)
      gradient.append("stop")
        .attr("offset", "100%")
        .attr("stop-color", targetColor);

      // 设置链接的颜色为渐变色
      d3.select(this).style("stroke", "url(#" + gradientID + ")");
    });

    // 修改节点矩形框的颜色
    svg.selectAll(".node rect")
      .style("stroke", "black") // 设置矩形框的边框颜色
      .style("stroke-width", "1.5px"); // 设置矩形框的边框粗细
  }
')

# 保存HTML文件
saveNetwork(p2, "sankey2_result.html")
# 保存PNG图片
webshot("sankey2_result.html", "sankey2_result.png", delay = 3)

cat("桑基图生成完成!结果已保存为HTML和PNG文件。\n")
cat("- 第一个桑基图:sankey1_result.html, sankey1_result.png\n")
cat("- 第二个桑基图:sankey2_result.html, sankey2_result.png\n")
---
title: "桑基图示例"
author: "Author"
date: "`r Sys.Date()`"
output: html_document
editor_options:
  chunk_output_type: console
---

```{r setup, include=FALSE}
knitr::opts_chunk$set(echo = TRUE)
```

## 准备工作

让我们首先安装和加载必要的包,并设置工作目录。

```{r load_packages}
# 检查并安装必要的包
packages <- c("networkD3", "dplyr", "htmlwidgets")
for (pkg in packages) {
  if (!requireNamespace(pkg, quietly = TRUE)) {
    install.packages(pkg)
  }
}

# 加载必要的包
library(networkD3)
library(dplyr)
```

## 复现一: 病毒传播桑基图

### 读取数据

```{r read_data1}
# 读取第一个示例数据
data <- read.csv("sankey1_data.csv", stringsAsFactors = FALSE)
head(data)
```

### 数据预处理

```{r process_data1}
# 分组汇总
data_summary <- data %>%
  group_by(Timeline, Lineages.Distribution, Geographic.Location, P.M.A.s) %>%
  summarise(Count = n(), .groups = 'drop')

# 定义每一层节点的顺序
timeline_order <- unique(data_summary$Timeline)
lineages_order <- rev(unique(data_summary$Lineages.Distribution))
geographic_order <- c("Russia", "Philippines", "Laos", "Cambodia", "India",
                     "Switzerland", "Thailand", "Vietnam", "China", "USA",
                     "Mexico", "Canada", "South Korea", "Japan")
geographic_order <- geographic_order[geographic_order %in% unique(data_summary$Geographic.Location)]
pmas_order <- sort(unique(data_summary$P.M.A.s), na.last = TRUE)

# 创建节点数据
nodes <- data.frame(name = c(timeline_order,
                            lineages_order,
                            geographic_order,
                            pmas_order))

# 创建链接数据
links <- data_summary %>%
  select(Timeline, Lineages.Distribution, Count) %>%
  rename(source = Timeline, target = Lineages.Distribution, value = Count) %>%
  bind_rows(
    data_summary %>% select(Lineages.Distribution, Geographic.Location, Count) %>%
      rename(source = Lineages.Distribution, target = Geographic.Location, value = Count),
    data_summary %>% select(Geographic.Location, P.M.A.s, Count) %>%
      rename(source = Geographic.Location, target = P.M.A.s, value = Count)
  ) %>%
  group_by(source, target) %>%
  summarise(value = sum(value), .groups = 'drop') %>%
  ungroup()

# 转换索引
links$IDsource <- match(links$source, nodes$name) - 1
links$IDtarget <- match(links$target, nodes$name) - 1

head(nodes)
head(links)
```

### 绘制桑基图

```{r plot_sankey1}
# 自定义颜色列表
customColors <- c("#1f77b4", "#ff7f0e", "#2ca02c", "#d62728", "#9467bd",
                 "#8c564b", "#e377c2", "#7f7f7f", "#bcbd22", "#17becf",
                 "#aec7e8", "#ffbb78", "#98df8a", "#ff9896", "#c5b0d5",
                 "#c49c94", "#f7b6d2", "#c7c7c7", "#dbdb8d", "#9edae5")

# 创建颜色比例字符串
colourScale <- sprintf('d3.scaleOrdinal().range(["%s"])',
                      paste(customColors, collapse = '", "'))

# 创建基础桑基图
p <- sankeyNetwork(Links = links,
                  Nodes = nodes,
                  Source = "IDsource",
                  Target = "IDtarget",
                  Value = "value",
                  NodeID = "name",
                  units = "T",
                  fontSize = 13,
                  nodeWidth = 30,
                  height = 600,
                  width = 1000,
                  nodePadding = 14,
                  iterations = 0,
                  colourScale = colourScale)

# 显示基础桑基图
p
```

### 添加渐变色效果

```{r gradient_sankey1}
# 添加渐变色效果和美化
p1 <- htmlwidgets::onRender(p, '
  function(el, x) {
    var svg = d3.select(el).select("svg");

    // 创建一个合法的ID, 防止名称中有空格或者-等特殊字符
    function createValidID(name) {
      if (!name) {
        return "unknown"; // 如果名称是null或undefined,返回一个默认值
      }
      // 将非字母数字字符替换为下划线,包括空格和-
      return name.replace(/[^a-zA-Z0-9-]/g, "_");
    }

    // 收集要删除的节点名称(NA)
    var nodesToRemove = [];
    svg.selectAll(".node").each(function(d) {
      if (!d.name || d.name === "NA") {
        nodesToRemove.push(d.name);
      }
    });

    // 删除标签为NA的节点及其直接相关的链接
    nodesToRemove.forEach(function(nodeName) {
      // 找到并删除与该节点相关的所有直接链接
      svg.selectAll(".link").filter(function(link) {
        return link.target.name === nodeName;
      }).remove();

      // 删除节点
      svg.selectAll(".node").filter(function(node) {
        return node.name === nodeName;
      }).remove();
    });

    // 创建渐变色
    svg.selectAll(".link").each(function(d) {
      // 使用 source.name 和 target.name 作为渐变ID的一部分
      var gradientID = "gradient-" + createValidID(d.source.name) + "-" + createValidID(d.target.name);

      // 创建渐变
      var gradient = svg.append("defs")
        .append("linearGradient")
        .attr("id", gradientID)
        .attr("gradientUnits", "userSpaceOnUse")
        .attr("x1", d.source.x + d.source.dx / 2)
        .attr("y1", d.source.y + d.source.dy / 2)
        .attr("x2", d.target.x + d.target.dx / 2)
        .attr("y2", d.target.y + d.target.dy / 2);

      // 起始颜色(源节点颜色)
      var sourceColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.source.name; }).select("rect").style("fill");
      var targetColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.target.name; }).select("rect").style("fill");

      gradient.append("stop")
        .attr("offset", "0%")
        .attr("stop-color", sourceColor);

      // 终止颜色(目标节点颜色)
      gradient.append("stop")
        .attr("offset", "100%")
        .attr("stop-color", targetColor);

      // 设置链接的颜色为渐变色
      d3.select(this).style("stroke", "url(#" + gradientID + ")");
    });

    // 修改节点矩形框的颜色
    svg.selectAll(".node rect")
      .style("stroke", "black") // 设置矩形框的边框颜色
      .style("stroke-width", "1.5px"); // 设置矩形框的边框粗细
  }
')

# 显示渐变效果桑基图
p1
```

## 复现二: 基因相关性桑基图

### 读取数据

```{r read_data2}
# 读取第二个示例数据
data2 <- read.csv("sankey2_data.csv", stringsAsFactors = FALSE)
head(data2)
```

### 数据预处理

```{r process_data2}
# 定义节点顺序
cluster_order <- unique(data2$cluster)
mRNA1_order <- unique(data2$mRNA1)
mRNA2_order <- unique(data2$mRNA2)

# 创建节点数据
nodes2 <- data.frame(name = c(cluster_order, mRNA1_order, mRNA2_order))

# 创建链接数据
links2 <- data2 %>%
  select(cluster, mRNA1, Freq) %>%
  rename(source = cluster, target = mRNA1, value = Freq) %>%
  bind_rows(
    data2 %>% select(mRNA1, mRNA2, Freq) %>%
      rename(source = mRNA1, target = mRNA2, value = Freq)
  ) %>%
  group_by(source, target) %>%
  summarise(value = sum(value), .groups = 'drop') %>%
  ungroup()

# 转换索引
links2$IDsource <- match(links2$source, nodes2$name) - 1
links2$IDtarget <- match(links2$target, nodes2$name) - 1

head(nodes2)
head(links2)
```

### 绘制桑基图

```{r plot_sankey2}
# 创建桑基图
p2 <- sankeyNetwork(Links = links2,
                   Nodes = nodes2,
                   Source = "IDsource",
                   Target = "IDtarget",
                   Value = "value",
                   NodeID = "name",
                   units = "T",
                   fontSize = 20,
                   nodeWidth = 15,
                   height = 600,
                   width = 800,
                   iterations = 0,
                   nodePadding = 10,
                   colourScale = colourScale)

# 显示桑基图
p2
```

### 添加渐变色效果

```{r gradient_sankey2}
# 添加渐变色效果和美化
p2_gradient <- htmlwidgets::onRender(p2, '
  function(el, x) {
    var svg = d3.select(el).select("svg");

    // 创建一个合法的ID, 防止名称中有空格或者-等特殊字符
    function createValidID(name) {
      if (!name) {
        return "unknown"; // 如果名称是null或undefined,返回一个默认值
      }
      // 将非字母数字字符替换为下划线,包括空格和-
      return name.replace(/[^a-zA-Z0-9-]/g, "_");
    }

    // 创建渐变色
    svg.selectAll(".link").each(function(d) {
      // 使用 source.name 和 target.name 作为渐变ID的一部分
      var gradientID = "gradient-" + createValidID(d.source.name) + "-" + createValidID(d.target.name);

      // 创建渐变
      var gradient = svg.append("defs")
        .append("linearGradient")
        .attr("id", gradientID)
        .attr("gradientUnits", "userSpaceOnUse")
        .attr("x1", d.source.x + d.source.dx / 2)
        .attr("y1", d.source.y + d.source.dy / 2)
        .attr("x2", d.target.x + d.target.dx / 2)
        .attr("y2", d.target.y + d.target.dy / 2);

      // 起始颜色(源节点颜色)
      var sourceColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.source.name; }).select("rect").style("fill");
      var targetColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.target.name; }).select("rect").style("fill");

      gradient.append("stop")
        .attr("offset", "0%")
        .attr("stop-color", sourceColor);

      // 终止颜色(目标节点颜色)
      gradient.append("stop")
        .attr("offset", "100%")
        .attr("stop-color", targetColor);

      // 设置链接的颜色为渐变色
      d3.select(this).style("stroke", "url(#" + gradientID + ")");
    });

    // 修改节点矩形框的颜色
    svg.selectAll(".node rect")
      .style("stroke", "black") // 设置矩形框的边框颜色
      .style("stroke-width", "1.5px"); // 设置矩形框的边框粗细
  }
')

# 显示渐变效果桑基图
p2_gradient
```

## 保存结果

```{r save_results, eval=FALSE}
# 保存HTML文件
saveNetwork(p1, "sankey1_result.html")
saveNetwork(p2_gradient, "sankey2_result.html")

# 如果需要保存为图片,可以安装并使用webshot包
# install.packages("webshot")
# webshot::install_phantomjs()
# library(webshot)
# webshot("sankey1_result.html", "sankey1_result.png", delay = 3)
# webshot("sankey2_result.html", "sankey2_result.png", delay = 3)
```
---
title: "动态交互桑基图"
author: "Author"
date: "`r Sys.Date()`"
output: html_document
editor_options:
  chunk_output_type: console
---

```{r setup, include=FALSE}
knitr::opts_chunk$set(echo = TRUE)
```

## 简介

<!--
今天来复现 2 个桑基图 (sankey),使用 networkD3 包进行代码复现,其优势在于生成的图片动态可交互。此外,ggsankey, ggalluvial 等也是 R 中常用来绘制桑基图的包。
-->

## 复现一: Nature Communications 文章

<!--
第一篇是 Nature Communications 文章中 (Sun, Y., Xing, J., Hong, S.L. et al. Untangling lineage introductions, persistence and transmission drivers of HP-PRRSV sublineage 8.7. Nat Commun 15, 8842 (2024). https://doi.org/10.1038/s41467-024-53076-w) 的 Fig.1

原图清晰地展示了样本的时空分布:

标签从前向后依次是:
时间:1994-1999年极少,2000-2005年感染率急剧上升。随后2006-2016年菌群快速扩张。
lineage 8的分类:大部分聚集在8.7亚系,位于中国。
地理分布:世界国家分布、中国省级分布,其中广东最多。

复现过程中学习到的技巧:
如何设置渐变色的连线?使用htmlwidgets::onRender()函数在 HTMLwidgets 上添加自定义的 JavaScript 渲染功能。极大地拓展了个性化定制功能,只有你想不到的没有它做不到的。
-->

### 加载R包,准备数据

```{r load_libraries_1}
# 加载必要的包
library(networkD3)
library(tidyverse)
library(readxl)
library(htmlwidgets)
library(webshot)

# 读取数据
data0 = read.csv("data1.csv", stringsAsFactors = FALSE)

data <- data0 %>%
  group_by(Timeline, `Lineages Distribution`, `Geographic Location`, `P.M.A.s`) %>%
  summarise(Count = n(), .groups = 'drop')

# 定义每一层节点的顺序
timeline_order <- unique(data$Timeline)
lineages_order <- rev(unique(data$`Lineages Distribution`))
geographic_order <- c("Russia", "Philippines", "Laos", "Cambodia", "India",
                      "Switzerland", "Thailand", "Vietnam", "China", "USA",
                      "Mexico", "Canada", "South Korea", "Japan")
pmas_order <- sort(unique(data$P.M.A.s), na.last = TRUE)

# 创建节点数据并按自定义顺序排序
nodes <- data.frame(name = c(timeline_order,
                             lineages_order,
                             geographic_order,
                             pmas_order))

# 创建链接数据
links <- data %>%
  select(Timeline, `Lineages Distribution`, Count) %>%
  rename(source = Timeline, target = `Lineages Distribution`, value = Count) %>%
  bind_rows(
    data %>% select(`Lineages Distribution`, `Geographic Location`, Count) %>%
      rename(source = `Lineages Distribution`, target = `Geographic Location`, value = Count),
    data %>% select(`Geographic Location`, `P.M.A.s`, Count) %>%
      rename(source = `Geographic Location`, target = `P.M.A.s`, value = Count)
  ) %>%
  group_by(source, target) %>%
  summarise(value = sum(value), .groups = 'drop') %>%
  ungroup()

# 将source和target转换为节点索引
links$IDsource <- match(links$source, nodes$name) - 1  # networkD3的索引从0开始
links$IDtarget <- match(links$target, nodes$name) - 1
```

<!--
此数据为随机编造数据,无实际意义,如需文末可以自助获取。

汇总summarise()每一个类别的样本个数。
创建节点数据并排序:先自定义每一级的节点顺序,并写入 nodes 数据框,这样最终图片中的节点就按照给定的顺序排列了。
创建链接数据:links 数据框,包含了链接的源节点、目标节点以及链接的值(频率或权重)。
节点和链接数据处理:使用match()函数将 source 和 target 字段转换为节点的索引,以便在sankeyNetwork()函数中使用。
-->

### 绘图

```{r plot_sankey_1}
# 自定义颜色列表
customColors <- c("#1f77b4", "#ff7f0e", "#2ca02c", "#d62728", "#9467bd",
                 "#8c564b", "#e377c2", "#7f7f7f", "#bcbd22", "#17becf",
                 "#aec7e8", "#ffbb78", "#98df8a", "#ff9896", "#c5b0d5",
                 "#c49c94", "#f7b6d2", "#c7c7c7", "#dbdb8d", "#9edae5")

# 创建颜色比例字符串
colourScale <- sprintf('d3.scaleOrdinal().range(["%s"])',
                       paste(customColors, collapse = '", "'))

p <- sankeyNetwork(Links = links,
              Nodes = nodes,
              Source = "IDsource",
              Target = "IDtarget",
              Value = "value",
              NodeID = "name",
              units = "T",
              fontSize = 13,
              nodeWidth = 30,
              height = 600,
              width = 1000,
              nodePadding = 14,
              iterations = 0,
              colourScale = colourScale)
p
```

<!--
使用d3.scaleOrdinal().range([...]) 来生成颜色列表。
使用 networkD3 包中的sankeyNetwork()函数创建 Sankey 图。
传递 links, nodes 数据框以及其他参数如 Source, Target, Value 来指定链接的源、目标和值的字段。
iterations = 0:保证节点按照给定顺序输出,若你的顺序还未知,就用默认值,通过增加迭代次数使图表布局更加优化,节点和链接更少地重叠和交叉;
nodePadding = 10:控制相邻节点之间的距离,以及节点与链接的间隙。
-->

### 渲染 Sankey 图

```{r render_sankey_1}
p1 <- htmlwidgets::onRender(p, '
  function(el, x) {
    var svg = d3.select(el).select("svg");

    // 创建一个合法的ID, 防止名称中有空格或者-等特殊字符
    function createValidID(name) {
      if (!name) {
        return "unknown"; // 如果名称是null或undefined,返回一个默认值
      }
      // 将非字母数字字符替换为下划线,包括空格和-
      return name.replace(/[^a-zA-Z0-9-]/g, "_");
    }


    // 收集要删除的节点名称(NA)
    var nodesToRemove = [];
    svg.selectAll(".node").each(function(d) {
      if (!d.name || d.name === "NA") {
        nodesToRemove.push(d.name);
      }
    });

    // 删除标签为NA的节点及其直接相关的链接
    nodesToRemove.forEach(function(nodeName) {
      // 找到并删除与该节点相关的所有直接链接
      svg.selectAll(".link").filter(function(link) {
        return link.target.name === nodeName;
      }).remove();

      // 删除节点
      svg.selectAll(".node").filter(function(node) {
        return node.name === nodeName;
      }).remove();
    });


    // 创建渐变色
    svg.selectAll(".link").each(function(d) {

      // 使用 source.name 和 target.name 作为渐变ID的一部分
      var gradientID = "gradient-" + createValidID(d.source.name) + "-" + createValidID(d.target.name);

      // 创建渐变
      var gradient = svg.append("defs")
        .append("linearGradient")
        .attr("id", gradientID)
        .attr("gradientUnits", "userSpaceOnUse")
        .attr("x1", d.source.x + d.source.dx / 2)
        .attr("y1", d.source.y + d.source.dy / 2)
        .attr("x2", d.target.x + d.target.dx / 2)
        .attr("y2", d.target.y + d.target.dy / 2);

      // 起始颜色(源节点颜色)
      var sourceColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.source.name; }).select("rect").style("fill");
      var targetColor = d3.select(el).selectAll(".node").filter(function(node) { return node.name === d.target.name; }).select("rect").style("fill");

      gradient.append("stop")
        .attr("offset", "0%")
        .attr("stop-color", sourceColor);

      // 终止颜色(目标节点颜色)
      gradient.append("stop")
        .attr("offset", "100%")
        .attr("stop-color", targetColor);

      // 设置链接的颜色为渐变色
      d3.select(this).style("stroke", "url(#" + gradientID + ")");
    });

    // 修改节点矩形框的颜色
    svg.selectAll(".node rect")
      .style("stroke", "black") // 设置矩形框的边框颜色
      .style("stroke-width", "1.5px"); // 设置矩形框的边框粗细
  }
')

p1
saveNetwork(p1,"sankey2.html")

# 保存
webshot("sankey2.html" , "sankey2.png")
```

<!--
使用htmlwidgets::onRender()函数在 HTMLwidgets 上添加自定义的 JavaScript 渲染功能。
JavaScript 函数中包括:
- 删除不需要的节点,图中除了 China,其他国家没有省级分布,sankeyNetwork()函数会归为 "NA" 节点,在这个例子中要删除。
- 创建连线的渐变色。
- 修改节点矩形框的颜色
生成的图片是动态可交互的,根据自己的审美随意调整顺序。
-->

## 复现二: Nature Metabolism 文章

<!--
第二篇是 Nature Metabolism 文章中 (Yu, S., Tang, Q., Lu, X. et al. Time of exercise differentially impacts bone growth in mice. Nat Metab 6, 1036–1052 (2024). https://doi.org/10.1038/s42255-024-01057-0) 的 Extended Data Fig.4e

这个图清晰地展示了基因之间的相关性。
-->

### 加载R包,准备数据

```{r load_libraries_2}
# 加载必要的包
library(networkD3)
library(tidyverse)
library(readxl)
library(htmlwidgets)
library(webshot)

# 读取数据
data = read.csv("data2.csv", stringsAsFactors = FALSE)

# 定义每一层节点的顺序
cluster_order <- unique(data$cluster)
mRNA1_order <- unique(data$mRNA1)
mRNA2_order <- unique(data$mRNA2)

# 创建节点数据并按自定义顺序排序
nodes <- data.frame(name = c(cluster_order, mRNA1_order, mRNA2_order))

# 创建链接数据
links <- data %>%
  select(cluster, mRNA1, Freq) %>%
  rename(source = cluster, target = mRNA1, value = Freq) %>%
  bind_rows(
    data %>% select(mRNA1, mRNA2, Freq) %>%
      rename(source = mRNA1, target = mRNA2, value = Freq),
  ) %>%
  group_by(source, target) %>%
  summarise(value = sum(value), .groups = 'drop') %>%
  ungroup()


# 将source和target转换为节点索引
links$IDsource <- match(links$source, nodes$name) - 1  # networkD3的索引从0开始
links$IDtarget <- match(links$target, nodes$name) - 1
```

<!--
这个数据是 mRNA 间相互作用强度的数据,其格式与前面文章的不同,可以直接跳过汇总步骤,然后按照前面的操作来创建 nodes 和 links 数据框。
-->

### 绘图

```{r plot_sankey_2}
# 自定义颜色列表
customColors <- c("#1f77b4", "#ff7f0e", "#2ca02c", "#d62728", "#9467bd",
                 "#8c564b", "#e377c2", "#7f7f7f", "#bcbd22", "#17becf",
                 "#aec7e8", "#ffbb78", "#98df8a", "#ff9896", "#c5b0d5",
                 "#c49c94", "#f7b6d2", "#c7c7c7", "#dbdb8d", "#9edae5")

# 创建颜色比例字符串
colourScale <- sprintf('d3.scaleOrdinal().range(["%s"])',
                       paste(customColors, collapse = '", "'))

p <- sankeyNetwork(Links = links,
                   Nodes = nodes,
                   Source = "IDsource",
                   Target = "IDtarget",
                   Value = "value",
                   NodeID = "name",
                   units = "T",
                   fontSize = 20,
                   nodeWidth = 15,
                   height = 600,
                   width = 800,
                   iterations = 0,
                   nodePadding = 10,
                   colourScale = colourScale)
p
```

<!--
和前面相比,参数值略有调整,后续的渲染函数完全一样。动态可交互的图片,让你随意调整到你想要的效果。
-->
这个专题已经做成确定性工具,调用后直接返回图片, 不需要 AI 现写代码。