plot8 · 代码 14 · 图 3 · 笔记 10 · 代码库专题
转录因子分析
代码库整理的专题,README 见原始目录。
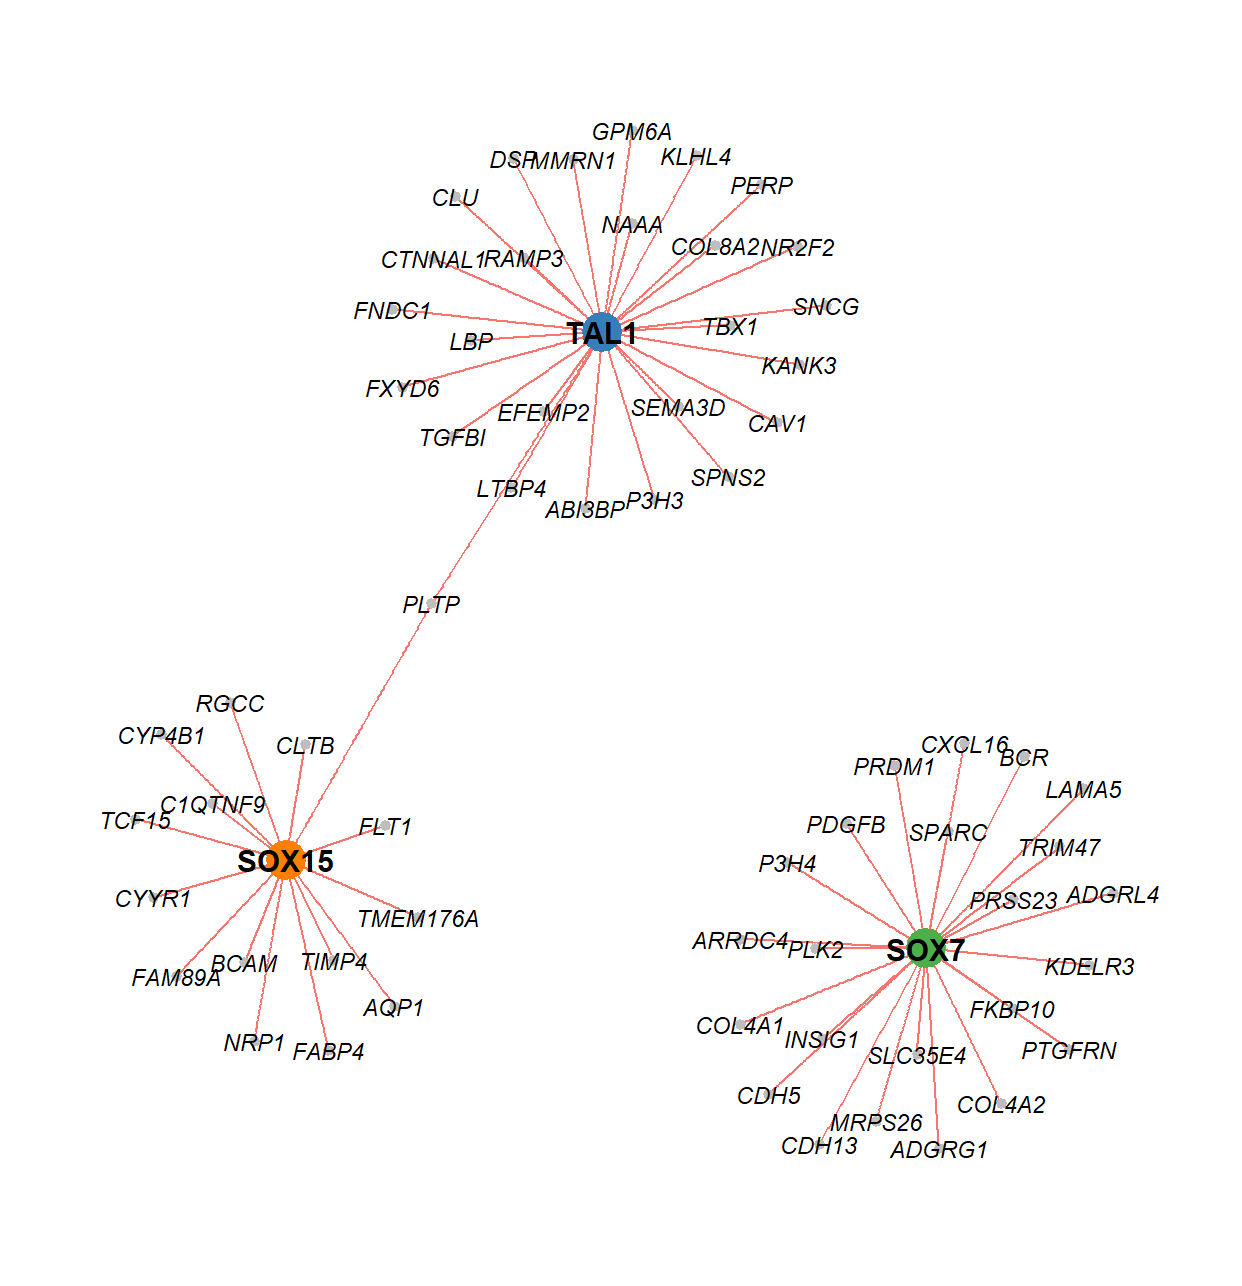
示例图 力导向布局01_pyscenic/05_TF_target网络/示例图_力导向布局.png
共 3 张:点缩略图切换主图,下载按钮跟随当前主图。
图源:示例图_力导向布局.png
分析代码
8 个源码文件,按目录顺序;本机绝对路径已替换为 ~。 代码可复制,但需要按自己的数据改路径与参数。
02_decoupler/01_数据准备与网络加载.r
# ==============================================================================
# decoupleR 实战 01:数据准备与调控网络加载
# 来源:KS 教程《Nature | 从 Bulk 数据中推断转录因子活性(decoupleR 实战)》
# 输入:bk_data.rds(含 counts / design / limma_ttop 三要素)
# 输出:decoupleR_input.rds(供 02-04 脚本直接读取)
# ==============================================================================

library(decoupleR)   # TF 活性推断核心包
library(dplyr)
library(tibble)
library(tidyr)
library(ggplot2)
library(pheatmap)
library(ggrepel)

# ---- 1. 读取教程示例数据 ------------------------------------------------------
# bk_data.rds 是一个 list,包含三样核心输入:
#   $counts     基因 x 样本 表达矩阵(带 gene 列)
#   $design     分组信息(样本 x 条件)
#   $limma_ttop limma 差异分析结果(WT vs KO,含 logFC / t / P.Value)
# ⚠️ 大数据不入库:请从本机原始目录提供该文件,或换成自己的数据
data <- readRDS("bk_data.rds")

# ---- 2. 表达矩阵 counts -------------------------------------------------------
# 行 = 基因,列 = 样本;缺失值填 0(decoupleR 不接受 NA)
counts <- data$counts %>%
  dplyr::mutate_if(~ any(is.na(.x)),
                   ~ dplyr::if_else(is.na(.x), 0, .x)) %>%
  tibble::column_to_rownames(var = "gene") %>%
  as.matrix()

head(counts)

# ---- 3. 分组信息 design -------------------------------------------------------
design <- data$design
head(design)

# ---- 4. 差异分析统计量 deg ----------------------------------------------------
# 重点保留 t 值:t = logFC / SE,同时携带方向和显著性,
# 是 decoupleR 推荐的对比水平活性推断输入(limma 的 t 或 DESeq2 的 stat 均可)
deg <- data$limma_ttop %>%
  dplyr::select(ID, logFC, t, P.Value) %>%
  dplyr::filter(!is.na(t)) %>%
  tibble::column_to_rownames(var = "ID") %>%
  as.matrix()

head(deg)

# ---- 5. 加载 CollecTRI 转录因子-靶基因调控网络 --------------------------------
# CollecTRI 整合 12 个数据库的 TF-target 调控关系,比 DoRothEA 覆盖更全、性能更好
# split_complexes = FALSE:蛋白复合物形式的 TF 不拆分成亚基单独计分
# 物种换小鼠时:get_collectri(organism = 'mouse', split_complexes = FALSE)
net <- decoupleR::get_collectri(organism = 'human',
                                split_complexes = FALSE)

head(net)
dim(net)

# ---- 6. 保存中间对象(供后续脚本直接读取) ------------------------------------
saveRDS(list(counts = counts, design = design, deg = deg, net = net),
        "decoupleR_input.rds")
02_decoupler/02_样本水平tf活性_ulm.r
# ==============================================================================
# decoupleR 实战 02:样本水平 TF 活性推断(ULM)+ top25 热图
# 原理:对每个样本 x 每个 TF,以靶基因的 mor 权重作预测变量、
#       该样本中靶基因的表达值作响应变量拟合线性模型,斜率的 t 值 = TF 活性得分
# 输入:decoupleR_input.rds(01 脚本产出)
# 输出:TF活性热图_top25.pdf(矢量 PDF)
# ==============================================================================

library(decoupleR)
library(dplyr)
library(tibble)
library(tidyr)
library(pheatmap)
library(RColorBrewer)

input  <- readRDS("decoupleR_input.rds")
counts <- input$counts
net    <- input$net

# ---- 1. ULM 活性推断 ----------------------------------------------------------
# minsize = 5:至少 5 个靶基因的 TF 才参与推断,过滤低支持度 TF
sample_acts <- decoupleR::run_ulm(mat = counts,
                                  net = net,
                                  .source = 'source',
                                  .target = 'target',
                                  .mor = 'mor',
                                  minsize = 5)

head(sample_acts)

# ---- 2. 长表转宽矩阵:行 = 样本(condition),列 = TF ---------------------------
n_tfs <- 25

sample_acts_mat <- sample_acts %>%
  tidyr::pivot_wider(id_cols = 'condition',
                     names_from = 'source',
                     values_from = 'score') %>%
  tibble::column_to_rownames('condition') %>%
  as.matrix()

# ---- 3. 取跨样本变异最大的前 25 个 TF -----------------------------------------
tfs <- sample_acts %>%
  dplyr::group_by(source) %>%
  dplyr::summarise(std = stats::sd(score)) %>%
  dplyr::arrange(-abs(std)) %>%
  head(n_tfs) %>%
  dplyr::pull(source)

sample_acts_mat <- sample_acts_mat[, tfs]

# ---- 4. 按 TF(列)做 z-score 标准化,便于跨 TF 比较相对活性高低 --------------
sample_acts_mat <- scale(sample_acts_mat)

# ---- 5. 配色与断点:RdBu 反转,红 = 高活性,蓝 = 低活性 -----------------------
colors <- rev(RColorBrewer::brewer.pal(n = 11, name = "RdBu"))
colors.use <- grDevices::colorRampPalette(colors = colors)(100)

my_breaks <- c(seq(-2, 0, length.out = ceiling(100 / 2) + 1),
               seq(0.05, 2, length.out = floor(100 / 2)))

# ---- 6. 热图(filename 直接落盘为矢量 PDF) ------------------------------------
pheatmap::pheatmap(mat = sample_acts_mat,
                   color = colors.use,
                   border_color = "white",
                   breaks = my_breaks,
                   cellwidth = 15,
                   cellheight = 15,
                   treeheight_row = 20,
                   treeheight_col = 20,
                   filename = "TF活性热图_top25.pdf")
02_decoupler/03_差异水平tf活性_ulm.r
# ==============================================================================
# decoupleR 实战 03:差异水平 TF 活性推断(WT vs KO 对比)+ 条形图
# 输入:差异分析 t 值矩阵 deg[, 't']——代表 WT vs KO 的整体变化方向与显著性
# 输出:TF活性差异_barplot.pdf(矢量 PDF)
# ==============================================================================

library(decoupleR)
library(dplyr)
library(ggplot2)
library(RColorBrewer)

input <- readRDS("decoupleR_input.rds")
deg   <- input$deg
net   <- input$net

n_tfs <- 25

# ---- 1. 用 t 值做 ULM:得到每个 TF 在"对比"水平的活性得分 ---------------------
contrast_acts <- decoupleR::run_ulm(mat = deg[, 't', drop = FALSE],
                                    net = net,
                                    .source = 'source',
                                    .target = 'target',
                                    .mor = 'mor',
                                    minsize = 5)

# ---- 2. 排名:正分按得分降序排,负分按绝对值降序排 ----------------------------
# 目的:让"最激活"和"最抑制"的 TF 都排到前面,一起进入 top n
f_contrast_acts <- contrast_acts %>%
  dplyr::mutate(rnk = NA)

msk <- f_contrast_acts$score > 0

f_contrast_acts[msk, 'rnk']   <- rank(-f_contrast_acts[msk, 'score'])
f_contrast_acts[!msk, 'rnk']  <- rank(-abs(f_contrast_acts[!msk, 'score']))

# ---- 3. 取排名靠前的 n_tfs 个 TF ----------------------------------------------
tfs <- f_contrast_acts %>%
  dplyr::arrange(rnk) %>%
  head(n_tfs) %>%
  dplyr::pull(source)

f_contrast_acts <- f_contrast_acts %>%
  dplyr::filter(source %in% tfs)

# ---- 4. 配色:蓝 = 活性下降,红 = 活性上升 ------------------------------------
colors <- rev(RColorBrewer::brewer.pal(n = 11, name = "RdBu")[c(2, 10)])

# ---- 5. 条形图 -----------------------------------------------------------------
p <- ggplot2::ggplot(data = f_contrast_acts,
                     mapping = ggplot2::aes(x = stats::reorder(source, score),
                                            y = score)) +
  ggplot2::geom_bar(mapping = ggplot2::aes(fill = score),
                    color = "black",
                    stat = "identity") +
  ggplot2::scale_fill_gradient2(low = colors[1],
                                mid = "whitesmoke",
                                high = colors[2],
                                midpoint = 0) +
  ggplot2::theme_minimal() +
  ggplot2::theme(axis.title = element_text(face = "bold", size = 12),
                 axis.text.x = ggplot2::element_text(angle = 45,
                                                     hjust = 1,
                                                     size = 10,
                                                     face = "bold"),
                 axis.text.y = ggplot2::element_text(size = 10,
                                                     face = "bold"),
                 panel.grid.major = element_blank(),
                 panel.grid.minor = element_blank()) +
  ggplot2::xlab("TFs")

p

# ---- 6. 输出矢量 PDF -----------------------------------------------------------
ggplot2::ggsave("TF活性差异_barplot.pdf", p,
                width = 10, height = 6, device = "pdf")

# ---- 7. 教程示例结果解读 -------------------------------------------------------
# GLI3、SPDEF:KO 中活性下降(可能受 FOXA2 正调控)
# MUC、NFKB1 :KO 中活性上升(可能被 FOXA2 抑制)
02_decoupler/04_tf靶基因火山图.r
# ==============================================================================
# decoupleR 实战 04:深入解析单个 TF 的靶基因变化(以 SP1 为例)
# 逻辑:把 CollecTRI 中该 TF 的靶基因(带 mor 调控符号)映射到差异分析结果上,
#       mor 与 t 同号(一致激活/抑制)标红,异号(矛盾)标蓝,其余灰色
# 输入:decoupleR_input.rds
# 输出:TF靶基因火山图_SP1.pdf(矢量 PDF)
# ==============================================================================

library(dplyr)
library(tibble)
library(ggplot2)
library(ggrepel)
library(RColorBrewer)

input <- readRDS("decoupleR_input.rds")
deg   <- input$deg
net   <- input$net

tf <- 'SP1'   # 换成任意感兴趣的 TF

# ---- 1. 取该 TF 的靶基因,并准备画图框 ----------------------------------------
df <- net %>%
  dplyr::filter(source == tf) %>%
  dplyr::arrange(target) %>%
  dplyr::mutate(ID = target, color = "3") %>%
  tibble::column_to_rownames('target')

# ---- 2. 只保留差异分析结果里也有的靶基因 --------------------------------------
inter <- sort(dplyr::intersect(rownames(deg), rownames(df)))

df <- df[inter, ]

df[, c('logfc', 't_value', 'p_value')] <- deg[inter, ]

# ---- 3. 着色逻辑 ---------------------------------------------------------------
# color = 1(红):mor 与 t 同号 → 靶基因变化支持 TF 活性方向(一致激活/一致抑制)
# color = 2(蓝):mor 与 t 异号 → 与 CollecTRI 调控方向矛盾
# color = 3(灰):mor 或 t 缺失 / 为 0
df <- df %>%
  dplyr::mutate(color = dplyr::if_else(mor > 0 & t_value > 0, '1', color)) %>%
  dplyr::mutate(color = dplyr::if_else(mor > 0 & t_value < 0, '2', color)) %>%
  dplyr::mutate(color = dplyr::if_else(mor < 0 & t_value > 0, '2', color)) %>%
  dplyr::mutate(color = dplyr::if_else(mor < 0 & t_value < 0, '1', color))

colors <- rev(RColorBrewer::brewer.pal(n = 11, name = "RdBu")[c(2, 10)])

# ---- 4. 火山图:点大小 = |mor|(调控权重强度) ---------------------------------
p <- ggplot2::ggplot(data = df,
                     mapping = ggplot2::aes(x = logfc,
                                            y = -log10(p_value),
                                            color = color,
                                            size = abs(mor))) +
  ggplot2::geom_point(size = 2.5,
                      color = "black") +
  ggplot2::geom_point(size = 1.5) +
  ggplot2::scale_colour_manual(values = c(colors[2], colors[1], "grey")) +
  ggrepel::geom_label_repel(mapping = ggplot2::aes(label = ID,
                                                   size = 1)) +
  ggplot2::theme_minimal() +
  ggplot2::theme(legend.position = "none") +
  ggplot2::geom_vline(xintercept = 0, linetype = 'dotted') +
  ggplot2::geom_hline(yintercept = 0, linetype = 'dotted') +
  ggplot2::ggtitle(tf)

p

# ---- 5. 输出矢量 PDF -----------------------------------------------------------
ggplot2::ggsave("TF靶基因火山图_SP1.pdf", p,
                width = 8, height = 6, device = "pdf")
03_rcistarget/01_rcistarget_hypoxia示例.r
# ============================================================
# RcisTarget:从基因集反推上游核心转录因子(motif 富集)
#
# 来源: 微信公众号《只会做差异分析不够:Cell Stem Cell用RcisTarget找到核心转录因子才能讲清机制》
# 原文: https://mp.weixin.qq.com/s/N9sndyeJgk7JvvSvEVAeGw
# 案例文献: Taubenschmid-Stowers et al. 2022, Cell Stem Cell
#           "8C-like cells capture the human zygotic genome activation
#            program in pluripotent stem cells"(Fig.3 用 RcisTarget 找到 DUX4/DUXA/KLF17)
# 蒸馏整理: hz-bioinfo-codes / 01_单细胞 / 1.7_转录因子分析 / 03_RcisTarget
#
# 核心逻辑:
#   基因集 → 在 motif ranking 数据库中看这些基因是否整体扎堆靠前
#   → AUC(富集程度)→ NES(标准化,>3 显著)→ motif→TF 注释
#   → 显著靶基因 → TF(motif)-gene 网络
#
# 标注约定:
#   ✅ 原文代码原样保留
#   🔶 [重构] 原文代码碎片化/伪代码,按官方 vignette 逻辑补全
#   ⚠️ [未验证] 原文函数在标准包中不存在或存疑
# ============================================================

# ------------------------------------------------------------
# 0. 环境准备 ✅
# ------------------------------------------------------------
Sys.setenv(LANGUAGE = "en")
options(stringsAsFactors = FALSE)
library(RcisTarget)

# ------------------------------------------------------------
# 1. 安装 motif 数据库(手动下载 tar.gz 后本地安装)✅
#    本脚本用的是 demo 库: hg19 + cisbp-only + TSS 上游 500bp
#    ⚠️ 复现 Cell Stem Cell 论文(TSS ± 10kb)需换用完整版
#       hg19/hg38 rankings 数据库(见 README「注意事项」)
# ------------------------------------------------------------
# 手动下载 RcisTarget.hg19.motifDBs.cisbpOnly.500bp(Bioconductor 页面提供 tar.gz)
pkg_targz <- "D:/Edge浏览器下载/RcisTarget.hg19.motifDBs.cisbpOnly.500bp_1.30.0.tar.gz"
if (!requireNamespace("RcisTarget.hg19.motifDBs.cisbpOnly.500bp", quietly = TRUE)) {
  if (!file.exists(pkg_targz)) {
    stop("找不到本地 tar.gz:", pkg_targz,
         "\n请把 pkg_targz 改成你实际文件路径(用 /)")
  }
  install.packages(pkg_targz, repos = NULL, type = "source")
}
library(RcisTarget.hg19.motifDBs.cisbpOnly.500bp)

# ------------------------------------------------------------
# 2. 准备基因集 ✅
#    输入: GeneSet.txt(每行一个基因 symbol,此处为缺氧相关基因)
#    输出: geneLists —— named list,后续所有分析围绕它
#    💡 换成自己的场景: DEG 上调基因 / cluster marker / WGCNA 模块 / 通路基因集
# ------------------------------------------------------------
geneList1 <- read.table("GeneSet.txt")[,1]
geneLists <- list(hypoxia = geneList1)
geneLists

# ------------------------------------------------------------
# 3. 加载 ranking + motif 注释(RcisTarget 两大核心资源)✅
# ------------------------------------------------------------
# motifRankings: 每个 motif 对全基因组的排序列表
#   排序依据 = 该 motif 在每个基因附近(此处 TSS 上游 500bp)的匹配强度
#   直观理解: 对每个 motif,都有一张"最可能被它调控的基因"排名表
data(hg19_500bpUpstream_motifRanking_cispbOnly)   # 注意对象名拼写是 cispb(官方如此)
motifRankings <- hg19_500bpUpstream_motifRanking_cispbOnly

# motifAnnotations: motif ID → 候选 TF(区分高置信/低置信)
data(hg19_motifAnnotation_cisbpOnly)
motifAnnotations <- hg19_motifAnnotation_cisbpOnly

# ------------------------------------------------------------
# 4. 一步法:cisTarget() ✅
#    把 "AUC → NES → 注释 → 显著基因" 打包成一步跑完
#    输出: motifEnrichmentTable_wGenes,每行一个 motif,
#          含 AUC/NES、注释 TF、预测显著基因列表
# ------------------------------------------------------------
motifEnrichmentTable_wGenes <- cisTarget(geneLists,
                                         motifRankings,
                                         motifAnnot = motifAnnotations)
motifEnrichmentTable_wGenes

# ------------------------------------------------------------
# 5. 分步法(与第 4 步等价,便于检查中间结果)
# ------------------------------------------------------------
# 5.1 计算 AUC ✅
#     对每个 motif,计算基因集在该 motif 排名列表前端的富集程度
motifs_AUC <- calcAUC(geneLists, motifRankings, nCores = 1)
motifs_AUC

# 5.2 AUC → NES + motif 注释 + 过滤 ✅
#     nesThreshold=3: 只保留 NES ≥ 3 的显著 motif
#     highlightTFs:   高亮你关心的 TF(此处缺氧案例关注 HIF1A/EPAS1)
motifEnrichmentTable <- addMotifAnnotation(
  motifs_AUC, nesThreshold = 3, motifAnnot = motifAnnotations,
  highlightTFs = list(hypoxia = c("HIF1A", "EPAS1"))
)
motifEnrichmentTable   # 此时还没有显著基因列表

# 5.3 给每个显著 motif 找"显著基因" 🔶 [重构](原文为 ... 省略写法)
#     在 motif 的基因 ranking 中找领先富集的一段基因 = 候选靶基因
#     method="aprox": 近似算法,速度快、离线友好(精确法为 "iCisTarget",更慢)
motifEnrichmentTable_wGenes2 <- addSignificantGenes(
  resultsTable = motifEnrichmentTable,
  geneSets     = geneLists,
  rankings     = motifRankings,
  maxRank      = 500,
  method       = "aprox"
)
motifEnrichmentTable_wGenes2

# ------------------------------------------------------------
# 6. AUC 直方图(诊断图)✅
#    所有 motif 的 AUC 分布;红线 = 由 NES=3 反推的 AUC 阈值位置,
#    红线右侧的 motif 更可能是关键调控 motif
# ------------------------------------------------------------
auc <- getAUC(motifs_AUC)["hypoxia", ]
hist(auc,
     main = "hypoxia",
     xlab = "AUC histogram",
     breaks = 100,
     col = "#ff000050",
     border = "darkred")
nes3 <- (3 * sd(auc)) + mean(auc)
abline(v = nes3, col = "red")

# ------------------------------------------------------------
# 7. Recovery curve(基因恢复曲线)🔶 [重构](原文为 ... 省略写法)
#    横轴: 在 motif ranking 里往后扫到第几名(maxRank)
#    曲线越靠前、上升越快 → 基因集越集中在 ranking 顶部 → motif 越相关
# ------------------------------------------------------------
selectedMotifs <- sample(motifEnrichmentTable$motif, 2)
par(mfrow = c(1, 2))
getSignificantGenes(geneSets         = geneLists$hypoxia,
                    rankings         = motifRankings,
                    signifMotifNames = selectedMotifs,
                    maxRank          = 5000,
                    plotCurve        = TRUE,
                    method           = "aprox")
par(mfrow = c(1, 1))

# ------------------------------------------------------------
# 8. Motif logo(展示前 10 个显著 motif)⚠️ [未验证]
#    原文调用 showLogo(resultsSubset),但 RcisTarget 主包未导出该函数,
#    可能是作者自定义辅助函数或笔误。
#    官方替代: ① DT::datatable 交互查看结果表(下方注释)
#              ② 用 motifStack/ universalmotif 依据 motif PWM 画 logo
#              ③ cisTarget 网页工具在线查看
# ------------------------------------------------------------
resultsSubset <- motifEnrichmentTable_wGenes[1:10, ]
# showLogo(resultsSubset)   # ⚠️ 原文写法,标准包中不存在

# 官方 vignette 的查看方式(交互表格):
# library(DT)
# datatable(as.data.frame(resultsSubset[, -which(names(resultsSubset) %in%
#          c("enrichedGenes", "TF_lowConf", "TF_highConf"))]))

# ------------------------------------------------------------
# 9. 提取高置信 TF 列表 🔶 [重构](原文为伪代码 lapply(split(...), ...))
#    TF_highConf 列内是分号分隔的 TF 串,按基因集拆开并去重
# ------------------------------------------------------------
tfCol <- "TF_highConf"   # 可换 "TF_lowConf" 看低置信注释
annotatedTFs <- lapply(
  split(motifEnrichmentTable_wGenes[[tfCol]],
        motifEnrichmentTable_wGenes$geneSet),
  function(x) unique(unlist(strsplit(x, "; ")))
)
annotatedTFs$hypoxia   # 该基因集对应的高置信 TF 向量

# ------------------------------------------------------------
# 10. TF(motif)-gene 交互网络(visNetwork)🔶 [重构](原文给的是流程骨架)
#     菱形节点 = motif,椭圆节点 = gene,
#     边 = 该 motif 预测调控该 gene(在 ranking 前端显著)
# ------------------------------------------------------------
library(reshape2)
library(visNetwork)

# 10.1 选前 3 个显著 motif,取 motif × gene 的 0/1 关联矩阵
signifMotifNames <- motifEnrichmentTable$motif[1:3]
incidenceMatrix <- getSignificantGenes(
  geneSets         = geneLists$hypoxia,
  rankings         = motifRankings,
  signifMotifNames = signifMotifNames,
  maxRank          = 5000,
  genesFormat      = "incidMatrix",
  method           = "aprox"
)$incidMatrix

# 10.2 关联矩阵 → 长表 edges(from=motif, to=gene)
edges <- melt(incidenceMatrix)
edges <- edges[edges$value > 0, ]
colnames(edges) <- c("from", "to", "value")

# 10.3 构建节点并画交互网络
motifNodes <- data.frame(id    = signifMotifNames,
                         label = signifMotifNames,
                         shape = "diamond",   # 菱形 = motif
                         color = "gold")
geneNodes  <- data.frame(id    = unique(edges$to),
                         label = unique(edges$to),
                         shape = "dot")       # 圆点 = gene
nodes <- rbind(motifNodes, geneNodes)

visNetwork(nodes, edges) %>%
  visIgraphLayout() %>%
  visOptions(highlightNearest = TRUE, nodesIdSelection = TRUE)

# ------------------------------------------------------------
# 会话信息(复现记录)
# ------------------------------------------------------------
# sessionInfo()
01_pyscenic/01_基础流程/01_pyscenic_r分析与可视化.r
#=======================================================================================
#                                   pySCENIC
#=======================================================================================
# 官方教程:
# [pySCENIC — pySCENIC latest documentation](https://pyscenic.readthedocs.io/en/latest/)

#----------------------以下内容在Linux环境中操作----------------------------------------

#安装下载及环境设置
# 安装一个conda,为什么安装他可以理解为Rstuido之于R,后期在环境设置、软件安装上很方便。
# wget https://repo.anaconda.com/miniconda/Miniconda3-latest-Linux-x86_64.sh
# bash安装,按照指引,都选yes,这样一些依赖的python包都安装了。
# bash Miniconda3-latest-Linux-x86_64.sh
#  激活conda环境
# source ~/.bashrc

#设置镜像
# conda config --add channels r
# conda config --add channels conda-forge
# conda config --add channels bioconda
# conda config --add channels https://mirrors.bfsu.edu.cn/anaconda/cloud/bioconda/
# conda config --add channels https://mirrors.bfsu.edu.cn/anaconda/cloud/conda-forge/
# conda config --add channels https://mirrors.bfsu.edu.cn/anaconda/pkgs/free/
# conda config --add channels https://mirrors.bfsu.edu.cn/anaconda/pkgs/main/
# conda config --set show_channel_urls yes

#安装pyscenic,并创建分析环境
# conda create -n pyscenic python=3.9  # 创建 pySCENIC 环境
# conda activate pyscenic
#安装依赖包
# conda install -y numpy
# conda install -y -c anaconda cytoolz
# conda install -y scanpy
#安装pyscenic
# pip install pyscenic
#文件下载
#TF注释
# wget https://resources.aertslab.org/cistarget/motif2tf/motifs-v9-nr.mgi-m0.001-o0.0.tbl
#转录组因子列表
# 下载地址
# https://github.com/aertslab/pySCENIC/tree/master/resources
#reference
# wget https://resources.aertslab.org/cistarget/databases/mus_musculus/mm10/refseq_r80/mc9nr/gene_based/mm10__refseq-r80__10kb_up_and_down_tss.mc9nr.feather
#文件准备
#pyscenic的输入文件是行为基因名,列为细胞ID的矩阵,所以在seurat对象中导出矩阵的时候需要转置一下,可以用标准化矩阵,也可以用counts矩阵,影响不大!
#表达矩阵、meta----R中进行
write.csv(t(as.matrix(human_data@assays$RNA@counts)),file = "sce_exp.csv")
# cellInfo <- human_data@meta.data[,c("celltype","nCount_RNA","nFeature_RNA")]
# colnames(cellInfo) <- c('CellType', 'nGene' ,'nUMI')
# head(cellInfo)
# write.csv(cellInfo, file = "cellInfo.csv")

#转化为loom文件,Linux下的python脚本
#编辑脚本
# vim trans.py
#输入以下内容
# import os, sys
# os.getcwd()
# os.listdir(os.getcwd())

# import loompy as lp
# import numpy as np
# import scanpy as sc
# x=sc.read_csv("sce_exp.csv")  # R 中导出的表达矩阵
# row_attrs = {"Gene": np.array(x.var_names)}
# col_attrs = {"CellID": np.array(x.obs_names)}
# lp.create("sce.loom", x.X.transpose(), row_attrs, col_attrs)

#保存并退出
#运行trans.py
# python trans.py

# ls
#这样在文件夹中会出现sce.loom文件,就是接下来输入pyscenic的文件。


#=======================================================================================
#                                   pySCENIC数据分析
#=======================================================================================

#分析第一步:GRN---运行完得到sce.adj.csv文件
##这一步的目的
#推断转录因子与提供的表达矩阵基因的共表达模块,基于grnboost2,R中时GENIE3
# pyscenic grn --num_workers 10 \
#   --sparse \
#   --method grnboost2 \
#   --output sce.adj.csv \
#   sce.loom \
#   hs_hgnc_tfs.txt

#分析第二步:RcisTarget---运行完得到sce.regulons.csv文件
#这一步的目的
#进行TF-motif富集分析,识别直接靶标
#得到转录因子(TF)与其对应的直接作用的靶点,称为regulon(每一个regulon是1个TF和其调控的靶基因)
# pyscenic ctx --num_workers 10 \
#   --output sce.regulons.csv \
#   --expression_mtx_fname sce.loom \
#   --all_modules \
#   --mask_dropouts \
#   --mode "dask_multiprocessing" \
#   --min_genes 10 \
#   --annotations_fname motifs-v9-nr.hgnc-m0.001-o0.0.tbl \
#   sce.adj.csv \
#   hg38__refseq-r80__10kb_up_and_down_tss.mc9nr.genes_vs_motifs.rankings.feather


#分析第三步:AUCell---运行完得到sce_SCENIC.loom文件,即分析结果
#这一步的目的
#使用AUCell对每个细胞的每个regulon活性进行评分。
# pyscenic aucell --num_workers 3 \
#   --output sce_SCENIC.loom \
#   sce.loom \
#   sce.regulons.csv


#############################################################################
#                                在R中可视化
#############################################################################

# setwd("path/to/your/pyscenic_workdir")
#加载分析包
library(SCopeLoomR)
library(AUCell)
library(SCENIC)
#可视化相关包,多加载点没毛病
library(dplyr)
library(KernSmooth)
library(RColorBrewer)
library(plotly)
library(BiocParallel)
library(grid)
library(ComplexHeatmap)
library(data.table)
library(ggplot2)
library(pheatmap)

##读取pyscenic第三步分析的文件sce_SCENIC.sce_SCENIC
sce_SCENIC <- open_loom("sce_SCENIC.loom")
# exprMat <- get_dgem(sce_SCENIC)#从sce_SCENIC文件提取表达矩阵
# exprMat_log <- log2(exprMat+1) # log处理
#这里的表达矩阵其实就是我们在pyscenic分析第一步的输入矩阵,可见这些文件都是在一起的

regulons_incidMat <- get_regulons(sce_SCENIC, column.attr.name="Regulons")
#提取第二步分析的regulons,column.attr.name填Regulons,具体按照实际情况提示选择
#也就是我们所输入的基因和找到的转录因子组成的表达文件
regulons <- regulonsToGeneLists(regulons_incidMat)#将上一步矩阵文件转化为list
class(regulons)


#提取pyscenic第三步分析中AUC结果
regulonAUC <- get_regulons_AUC(sce_SCENIC, column.attr.name='RegulonsAUC')
regulonAucThresholds <- get_regulon_thresholds(sce_SCENIC)

#以上就是一些主要文件了、够后续分析和可视化
#####################################################################################
##==============================加载seurat对象、RSS分析=======================================
#在可视化之前,我们再做一个分析,计算RSS值,计算regulon特异性评分
human_data <- readRDS("~/Pyscenic/human_data.rds")
cellinfo <- human_data@meta.data[,c('celltype','group',"nFeature_RNA","nCount_RNA")]#细胞meta信息
colnames(cellinfo)=c('celltype', 'group','nGene' ,'nUMI')
######计算细胞特异性TF
#在实际数据分析应用中,我认为比较靠谱的应用在于,细胞分了亚群,例如macrophage,有不同的特征
#我们可以查看不同亚群特异性的TF,有助于了解亚群的功能!!!!
cellTypes <-  as.data.frame(subset(cellinfo,select = 'celltype'))
selectedResolution <- "celltype"
sub_regulonAUC <- regulonAUC

rss <- calcRSS(AUC=getAUC(sub_regulonAUC),#从aucellresults获取AUC矩阵
               cellAnnotation=cellTypes[colnames(sub_regulonAUC),
                                        selectedResolution])

rss=na.omit(rss)#去除含有NA的行
#可视化细胞特异性TF
rssPlot <-
  plotRSS(
    rss,
    zThreshold = 3,
    cluster_columns = FALSE,
    order_rows = TRUE,
    thr=0.1,
    varName = "cellType",
    col.low = '#330066',
    col.mid = '#66CC66',
    col.high = '#FFCC33')

rssPlot

#提取数据,可以自己可视化dotplot,或者热图
rss_data <- rssPlot$plot$data
# devtools::install_github("XiaoLuo-boy/ggheatmap")
library(ggheatmap)
library(reshape2)
rss_data<-dcast(rss_data,
                Topic~rss_data$cellType,
                value.var = 'Z')
rownames(rss_data) <- rss_data[,1]
rss_data <- rss_data[,-1]
colnames(rss_data)
col_ann <- data.frame(group= c(rep("Neutrophil",1),
                               rep("Macrophage",1),
                               rep("mDC",1),
                               rep("T cell",1),
                               rep("Mast",1)))#列注释
rownames(col_ann) <- colnames(rss_data)
groupcol <- c("#D9534F", "#96CEB4", "#CBE86B", "#EDE574", "#0099CC")
names(groupcol) <- c("Neutrophil","Macrophage","mDC", "T cell","Mast")
col <- list(group=groupcol)

text_columns <- sample(colnames(rss_data),0)#不显示列名

p <- ggheatmap(rss_data,color=colorRampPalette(c('#1A5592','white',"#B83D3D"))(100),
               cluster_rows = T,cluster_cols = F,scale = "row",
               annotation_cols = col_ann,
               annotation_color = col,
               legendName="Relative value",
               text_show_cols = text_columns)
p

######既然可以分析细胞中的特异性TF,那么也可以分析样本中特异性的TF
#我们可以提取某一个细胞的表达矩阵,做pyscenic,后期再进行RSS分析的时候
#可以使用样本,就可以看出哪些TF是这个样本细胞中特异性的TF,这样生物学意义也就有了
##############################################################################

##==============================TF_AUC与seurat结合===========================
#普通展示
next_regulonAUC <- regulonAUC[,match(colnames(human_data),colnames(regulonAUC))]
dim(next_regulonAUC)#将AUC结果于seurat对象结合

regulon_AUC <- regulonAUC@NAMES
human_data@meta.data = cbind(human_data@meta.data ,t(assay(next_regulonAUC[regulon_AUC,])))

#自己选定感兴趣的或者比较重要的转录因子,这里我是随机的
TF_plot <- c("ZNF561(+)","FOXP3(+)","YY1(+)","HOXB2(+)",
             "TBX21(+)","TCF12(+)","STAT2(+)","SOX21(+)",
             "RBBP5(+)","NR2F6(+)","NELFE(+)","MAFG(+)")

DotPlot(human_data, features = TF_plot)+
  theme_bw()+
  theme(panel.grid = element_blank(),
        axis.text.x=element_text(hjust =1,vjust=1, angle = 45))+
  labs(x=NULL,y=NULL)+guides(size=guide_legend(order=3))

####

DotPlot(human_data, features = TF_plot, group.by = 'group')+
  theme_bw()+
  theme(panel.grid = element_blank(),
        axis.text.x=element_text(hjust =1,vjust=1, angle = 45))+
  theme(legend.direction = "horizontal",
        legend.position = "bottom")+
  labs(x=NULL,y=NULL)

###
FeaturePlot(human_data, features ="FOXP3(+)")


#############################################################################

##==============================TF平均表达活性===========================

cellsPerGroup <- split(rownames(cellTypes),
                       cellTypes[,selectedResolution])
#去除extend的TF
# sub_regulonAUC <- sub_regulonAUC[onlyNonDuplicatedExtended(rownames(sub_regulonAUC)),]
# dim(sub_regulonAUC)

#计算平均表达
regulonActivity_byGroup <- sapply(cellsPerGroup,
                                  function(cells)
                                    rowMeans(getAUC(sub_regulonAUC)[,cells]))

#scale处理\类似于热图数据的标准化
regulonActivity_byGroup_Scaled <- t(scale(t(regulonActivity_byGroup),
                                          center = T, scale=T))


regulonActivity_byGroup_Scaled=na.omit(regulonActivity_byGroup_Scaled)

#热图
hm <- draw(ComplexHeatmap::Heatmap(regulonActivity_byGroup_Scaled, name="Regulon activity",
                                   row_names_gp=grid::gpar(fontsize=6),
                                   show_row_names = F))
hm


################################################------------------------
#------rank可视化rss-----------------------------------------------------

B_rss <- as.data.frame(rss)#rss特异性TF结果
#需要作图的细胞类型
celltype <- c("Neutrophil","Macrophage","mDC","T cell","Mast")
rssRanklist <- list()

for(i in 1:length(celltype)) {

  data_rank_plot <- cbind(as.data.frame(rownames(B_rss)),
                          as.data.frame(B_rss[,celltype[i]]))#提取数据

  colnames(data_rank_plot) <- c("TF", "celltype")
  data_rank_plot=na.omit(data_rank_plot)#去除NA
  data_rank_plot <- data_rank_plot[order(data_rank_plot$celltype,decreasing=T),]#降序排列
  data_rank_plot$rank <- seq(1, nrow(data_rank_plot))#添加排序

  p <- ggplot(data_rank_plot, aes(x=rank, y=celltype)) +
    geom_point(size=3, shape=16, color="#1F77B4",alpha =0.4)+
    geom_point(data = data_rank_plot[1:6,],
               size=3, color='#DC050C')+ #选择前6个标记,自行按照需求选择
    theme_bw()+
    theme(axis.title = element_text(colour = 'black', size = 12),
          axis.text = element_text(colour = 'black', size = 10),
          axis.text.x = element_blank(),
          axis.ticks.x = element_blank())+
    labs(x='Regulons Rank', y='Specificity Score',title =celltype[i])+
    geom_text_repel(data= data_rank_plot[1:6,],
                    aes(label=TF), color="black", size=3, fontface="italic",
                    arrow = arrow(ends="first", length = unit(0.01, "npc")), box.padding = 0.2,
                    point.padding = 0.3, segment.color = 'black',
                    segment.size = 0.3, force = 1, max.iter = 3e3)
  rssRanklist[[i]] <- p
}


library(cowplot)

plot_grid(rssRanklist[[1]],rssRanklist[[2]],rssRanklist[[3]],
          rssRanklist[[4]],rssRanklist[[5]],ncol=3)


#=======================================================================================
#                              pySCENIC的差异分析及其他思路
#=======================================================================================
#加载R包
library(limma)
library(SCENIC)
library(AUCell)
library(data.table)


anaAUC <- regulonAUC
anaAUC <- anaAUC[onlyNonDuplicatedExtended(rownames(anaAUC)),]
ana.cellinfo<-human_data@meta.data#细胞信息

#选取需要分析的细胞,这里我们以T cell为例子
Tcell.cellinfo <- subset(ana.cellinfo, ana.cellinfo$celltype=='T cell')
targets<-data.table(FileName=rownames(Tcell.cellinfo),Target=Tcell.cellinfo$group)#提取组合分组

#接下来其实就是常规的差异分析了
lev<-unique(targets$Target)
f <- factor(targets$Target, levels=lev)
design <- model.matrix(~0+f) #样本矩阵
colnames(design) <- lev #design矩阵重命名

eset=getAUC(anaAUC) #获取所有细胞TF的AUC值
eset=eset[,targets$FileName]#我们只选取要分析的T细胞
eset<-t(scale(t(eset))) #scale

#比较分析limma
cont.wt <- makeContrasts("GM-BM",levels=design) #GM vs BM
fit <- lmFit(eset, design)
fit2 <- contrasts.fit(fit, cont.wt)
fit2 <- eBayes(fit2)
tT=topTable(fit2, adjust="BH",sort.by="logFC",n=Inf)#差异分析结果

tT = subset(tT, select=c("adj.P.Val","P.Value","logFC"))
colnames(tT)=c("FDR","P.Value","logFC")#选择关键的三列即可
write.table(tT,file="Tcell_TF_GM_BM.csv",sep="\t",quote=F)#保存结果

#接下来就可以按照不同的阈值筛选显著的TF了,其实这样的差异分析对于结果的解释和
#应用上更有说服力,这样我们可以直观的看到某些转录因子在不同细胞状态下的差异
#可视化的话可以用热图、火山图等展示。

logFoldChange<-0.5
adjustP<-0.05
diffSig <- tT[with(tT, (abs(logFC)>logFoldChange & FDR < adjustP )), ]#显著筛选
diffSig=na.omit(diffSig)
rownames(diffSig)<-gsub("\\(","",rownames(diffSig))
rownames(diffSig)<-gsub("\\)","",rownames(diffSig))
rownames(diffSig)<-gsub("\\+","",rownames(diffSig))
write.csv(diffSig, file = "diffSig_TF.csv")


#我们用热图展示以下差异结果
#先计算每个样本细胞的平均表达值
regulonActivity_byCellType <- sapply(split(rownames(Tcell.cellinfo), Tcell.cellinfo$orig.ident),
                                     function(cells) rowMeans(getAUC(anaAUC)[,cells]))
regulonActivity_byCellType_Scaled <- regulonActivity_byCellType
#这里有一个基础知识,很多文章展示TF不显示+号,用gsub函数就可以去除
rownames(regulonActivity_byCellType_Scaled)<-gsub("\\(","",rownames(regulonActivity_byCellType_Scaled))
rownames(regulonActivity_byCellType_Scaled)<-gsub("\\)","",rownames(regulonActivity_byCellType_Scaled))
rownames(regulonActivity_byCellType_Scaled)<-gsub("\\+","",rownames(regulonActivity_byCellType_Scaled))

#选择差异显著的TF进行可视化
selTF <- c("YY1","JUND","BCLAF1","SAP30","NR3C1","TAF7","ZNF148",
           "UBTF","FOS","ELF1","MXI1", "ZFX","ZMIZ1","TWIST1",
           "CEBPD","HOXD9","ETV4","TFDP1","BRF1","ZNF423","ZNF420",
           "HDAC2","GLIS1")

sel_regulonActivity_byCellType_Scaled <- regulonActivity_byCellType_Scaled[selTF,]

annotation_col = data.frame(group = c("BM","BM","BM","BM", "GM", "GM"))
rownames(annotation_col)<-colnames(regulonActivity_byCellType_Scaled)
ann_colors =  list(group = c("BM" = "#619cff", "GM" = "#f8766d"))

pheatmap::pheatmap(sel_regulonActivity_byCellType_Scaled,
                   color=colorRampPalette(c("#00a9ff","white","#F8766D"))(100),
                   breaks=seq(-2, 2, length.out = 100),
                   border_color=NA,
                   cluster_rows = F,
                   cluster_cols=F,
                   annotation_col = annotation_col,
                   annotation_colors = ann_colors,
                   scale="row",
                   main = "T cell TF")

#=======================================================================================
#                                   pySCENIC 转录因子与靶基因
#=======================================================================================
#我们还可以可视化感兴趣的TF调控的靶基因
#TF与靶基因的关系在pyscenic分析得到的第二个文件

sce_regulons <- read.csv("sce.regulons.csv")
sce_regulons <- sce_regulons[-2, ]
colnames(sce_regulons) <- sce_regulons[1,]
sce_regulons <- sce_regulons[-1, ]
colnames(sce_regulons) <- c("TF","ID","AUC","NES","MotifSimilarityQvalue","OrthologousIdentity",
                            "Annotation","Context","TargetGenes","RankAtMax")

#举例子我这里关注FOXP3和TGIF1这两个TF

FOXP3 <- subset(sce_regulons, TF=='FOXP3')
FOXP3 <- FOXP3[which(FOXP3$AUC>0.1),]
FOXP3 <- FOXP3[, c("TF","TargetGenes")]
FOXP3$TargetGenes <-gsub("\\[","",FOXP3$TargetGenes)
FOXP3$TargetGenes <-gsub("\\]","",FOXP3$TargetGenes)
FOXP3$TargetGenes <-gsub("\\(","",FOXP3$TargetGenes)
FOXP3$TargetGenes <-gsub("\\)","",FOXP3$TargetGenes)
FOXP3$TargetGenes <-gsub("\\'","",FOXP3$TargetGenes)
library(stringr)
split_FOXP3<-str_split(FOXP3$TargetGenes,",")
FOXP31 <- as.data.frame(split_FOXP3[[1]])
FOXP32<- as.data.frame(split_FOXP3[[2]])
FOXP33<-as.data.frame(split_FOXP3[[3]])
FOXP32<-as.data.frame(split_FOXP3[[4]])
FOXP35<- as.data.frame(split_FOXP3[[5]])

names(FOXP31) <- 'TF'
names(FOXP32) <- 'TF'
names(FOXP33) <- 'TF'
names(FOXP34) <- 'TF'
names(FOXP35) <- 'TF'

FOXP3 <- rbind(FOXP31,FOXP32,FOXP33,FOXP34,FOXP35)

FOXP3_target <- FOXP3[seq(1,nrow(FOXP3),2), ]
FOXP3_score <- FOXP3[seq(0,nrow(FOXP3),2), ]

FOXP3_gene <- data.frame(FOXP3_target,FOXP3_score)
FOXP3_gene <- FOXP3_gene[!duplicated(FOXP3_gene$FOXP3_target), ]
FOXP3_gene$gene <- 'FOXP3'
colnames(FOXP3_gene) <- c("target","score",'tf')

#同理得到TGIF1及其靶基因,此处省略1万字
#two thousand years later
#TGIF1_gene

TF_target <- rbind(FOXP3_gene,TGIF1_gene)
TF_target$score <- as.numeric(TF_target$score)
###接下来就是网络图了

#节点数据
paths <- c("FOXP3", "TGIF1")#列重命名
nodelist <- list()
for (i in 1:length(paths)){
  node <- subset(TF_target, tf == paths[i])#提取数据

  nodes <- data.frame(name = unique(union(node$tf, node$target)))#整理为datafram
  nodes$value <- c(sum(node$score)/10, node$score)#加上values

  nodelist[[i]] <- nodes
}  #提取每个大节点数据


nodes <- rbind(nodelist[[1]],nodelist[[2]])#将三个节点文件合并
nodes$cluster <- c(rep("FOXP3",1),rep("FOXP3_gene",20),
                   rep("TGIF1",1),rep("TGIF1_gene",6))#分组,为了后续颜色设置

edges <- TF_target[c("tf","target","score")]#边缘文件
edges$class <- edges$tf

library(ggraph)
library(tidygraph)
layout_cir <- tbl_graph(nodes = nodes, edges = edges)#构建ggraph作图文件
#作图
ggraph(layout_cir,layout='linear',circular = TRUE) +#选择circle
  geom_node_point(aes(size=value,colour = cluster))+#节点,大小用我们赋的值表示,颜色用分组
  geom_node_text(aes(x = 1.03 * x,
                     y = 1.03 * y,
                     label=name,
                     color=cluster,
                     angle = -((-node_angle(x, y) + 90) %% 180) + 90),
                 hjust='outward') +#文字设置。x,y是为了调整位置。angle是为了调整角度,以后其他所有网络图angle都用此公式,文字会向外发散排列
  geom_edge_arc(aes(colour=class))+#连线为曲线
  theme_void()+#theme主题
  theme(legend.position = "none")+
  scale_colour_manual(values =c('#407972',
                                '#961E28',
                                '#D46724',
                                '#0f8096'))+#节点颜色
  scale_edge_colour_manual(values = c('#961E28',
                                      '#D46724',
                                      '#0f8096'))+#连线颜色
  scale_size_continuous(range = c(2,8))+#点的大小范围设置
  coord_cartesian(xlim=c(-1.5,1.5),ylim = c(-1.5,1.5))#设置坐标位置,防止图溢出作图边界显示不全
01_pyscenic/01_基础流程/02_seurat矩阵转loom.py
"""Convert a Seurat-exported expression CSV to a pySCENIC loom file.

The CSV must have genes in rows and cells in columns, matching the export
from the R workflow in ``01_pySCENIC_R分析与可视化.R``.
"""

import argparse

import loompy as lp
import numpy as np
import scanpy as sc


def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--input", default="sce_exp.csv", help="expression CSV")
    parser.add_argument("--output", default="sce.loom", help="output loom")
    args = parser.parse_args()

    expression = sc.read_csv(args.input)
    row_attrs = {"Gene": np.asarray(expression.var_names)}
    col_attrs = {"CellID": np.asarray(expression.obs_names)}
    lp.create(args.output, expression.X.transpose(), row_attrs, col_attrs)


if __name__ == "__main__":
    main()
01_pyscenic/01_基础流程/03_pyscenic命令.sh
#!/usr/bin/env bash
set -euo pipefail

# Required inputs. Set these before running, for example:
# TF_LIST=hs_hgnc_tfs.txt \
# MOTIF_ANNOTATIONS=motifs-v9-nr.hgnc-m0.001-o0.0.tbl \
# RANKINGS_DB=hg38__refseq-r80__10kb_up_and_down_tss.mc9nr.genes_vs_motifs.rankings.feather \
# ./03_pySCENIC命令.sh

INPUT_LOOM="${INPUT_LOOM:-sce.loom}"
ADJACENCIES="${ADJACENCIES:-sce.adj.csv}"
REGULONS="${REGULONS:-sce.regulons.csv}"
OUTPUT_LOOM="${OUTPUT_LOOM:-sce_SCENIC.loom}"
THREADS="${THREADS:-10}"
AUCell_THREADS="${AUCell_THREADS:-3}"

: "${TF_LIST:?Set TF_LIST to the species-appropriate TF list}"
: "${MOTIF_ANNOTATIONS:?Set MOTIF_ANNOTATIONS to the motif annotation table}"
: "${RANKINGS_DB:?Set RANKINGS_DB to the cisTarget rankings database}"

pyscenic grn \
  --num_workers "$THREADS" \
  --sparse \
  --method grnboost2 \
  --output "$ADJACENCIES" \
  "$INPUT_LOOM" \
  "$TF_LIST"

pyscenic ctx \
  --num_workers "$THREADS" \
  --output "$REGULONS" \
  --expression_mtx_fname "$INPUT_LOOM" \
  --all_modules \
  --mask_dropouts \
  --mode dask_multiprocessing \
  --min_genes 10 \
  --annotations_fname "$MOTIF_ANNOTATIONS" \
  "$ADJACENCIES" \
  "$RANKINGS_DB"

pyscenic aucell \
  --num_workers "$AUCell_THREADS" \
  --output "$OUTPUT_LOOM" \
  "$INPUT_LOOM" \
  "$REGULONS"